GCP BigLake Iceberg
GCP BigLake Icebergコネクターは、Google Cloud上のBigLake Metastoreによって管理されるApache Icebergテーブルと連携します。このコネクターは、BigLake APIを通じてテーブルを直接管理し、BigQuery Jobs APIを通じてデータをロードまたはクエリし、組み込みのポーリングで長時間実行されるジョブを自動的に処理します。
コミュニティライブラリからGCP BigLake Icebergをインストール
次の手順を実行して、コミュニティライブラリからGCP BigLake Icebergコネクターをインストールします:
レシピエディターを開き、コネクターを検索します。または、コミュニティライブラリでコネクターを検索できます。
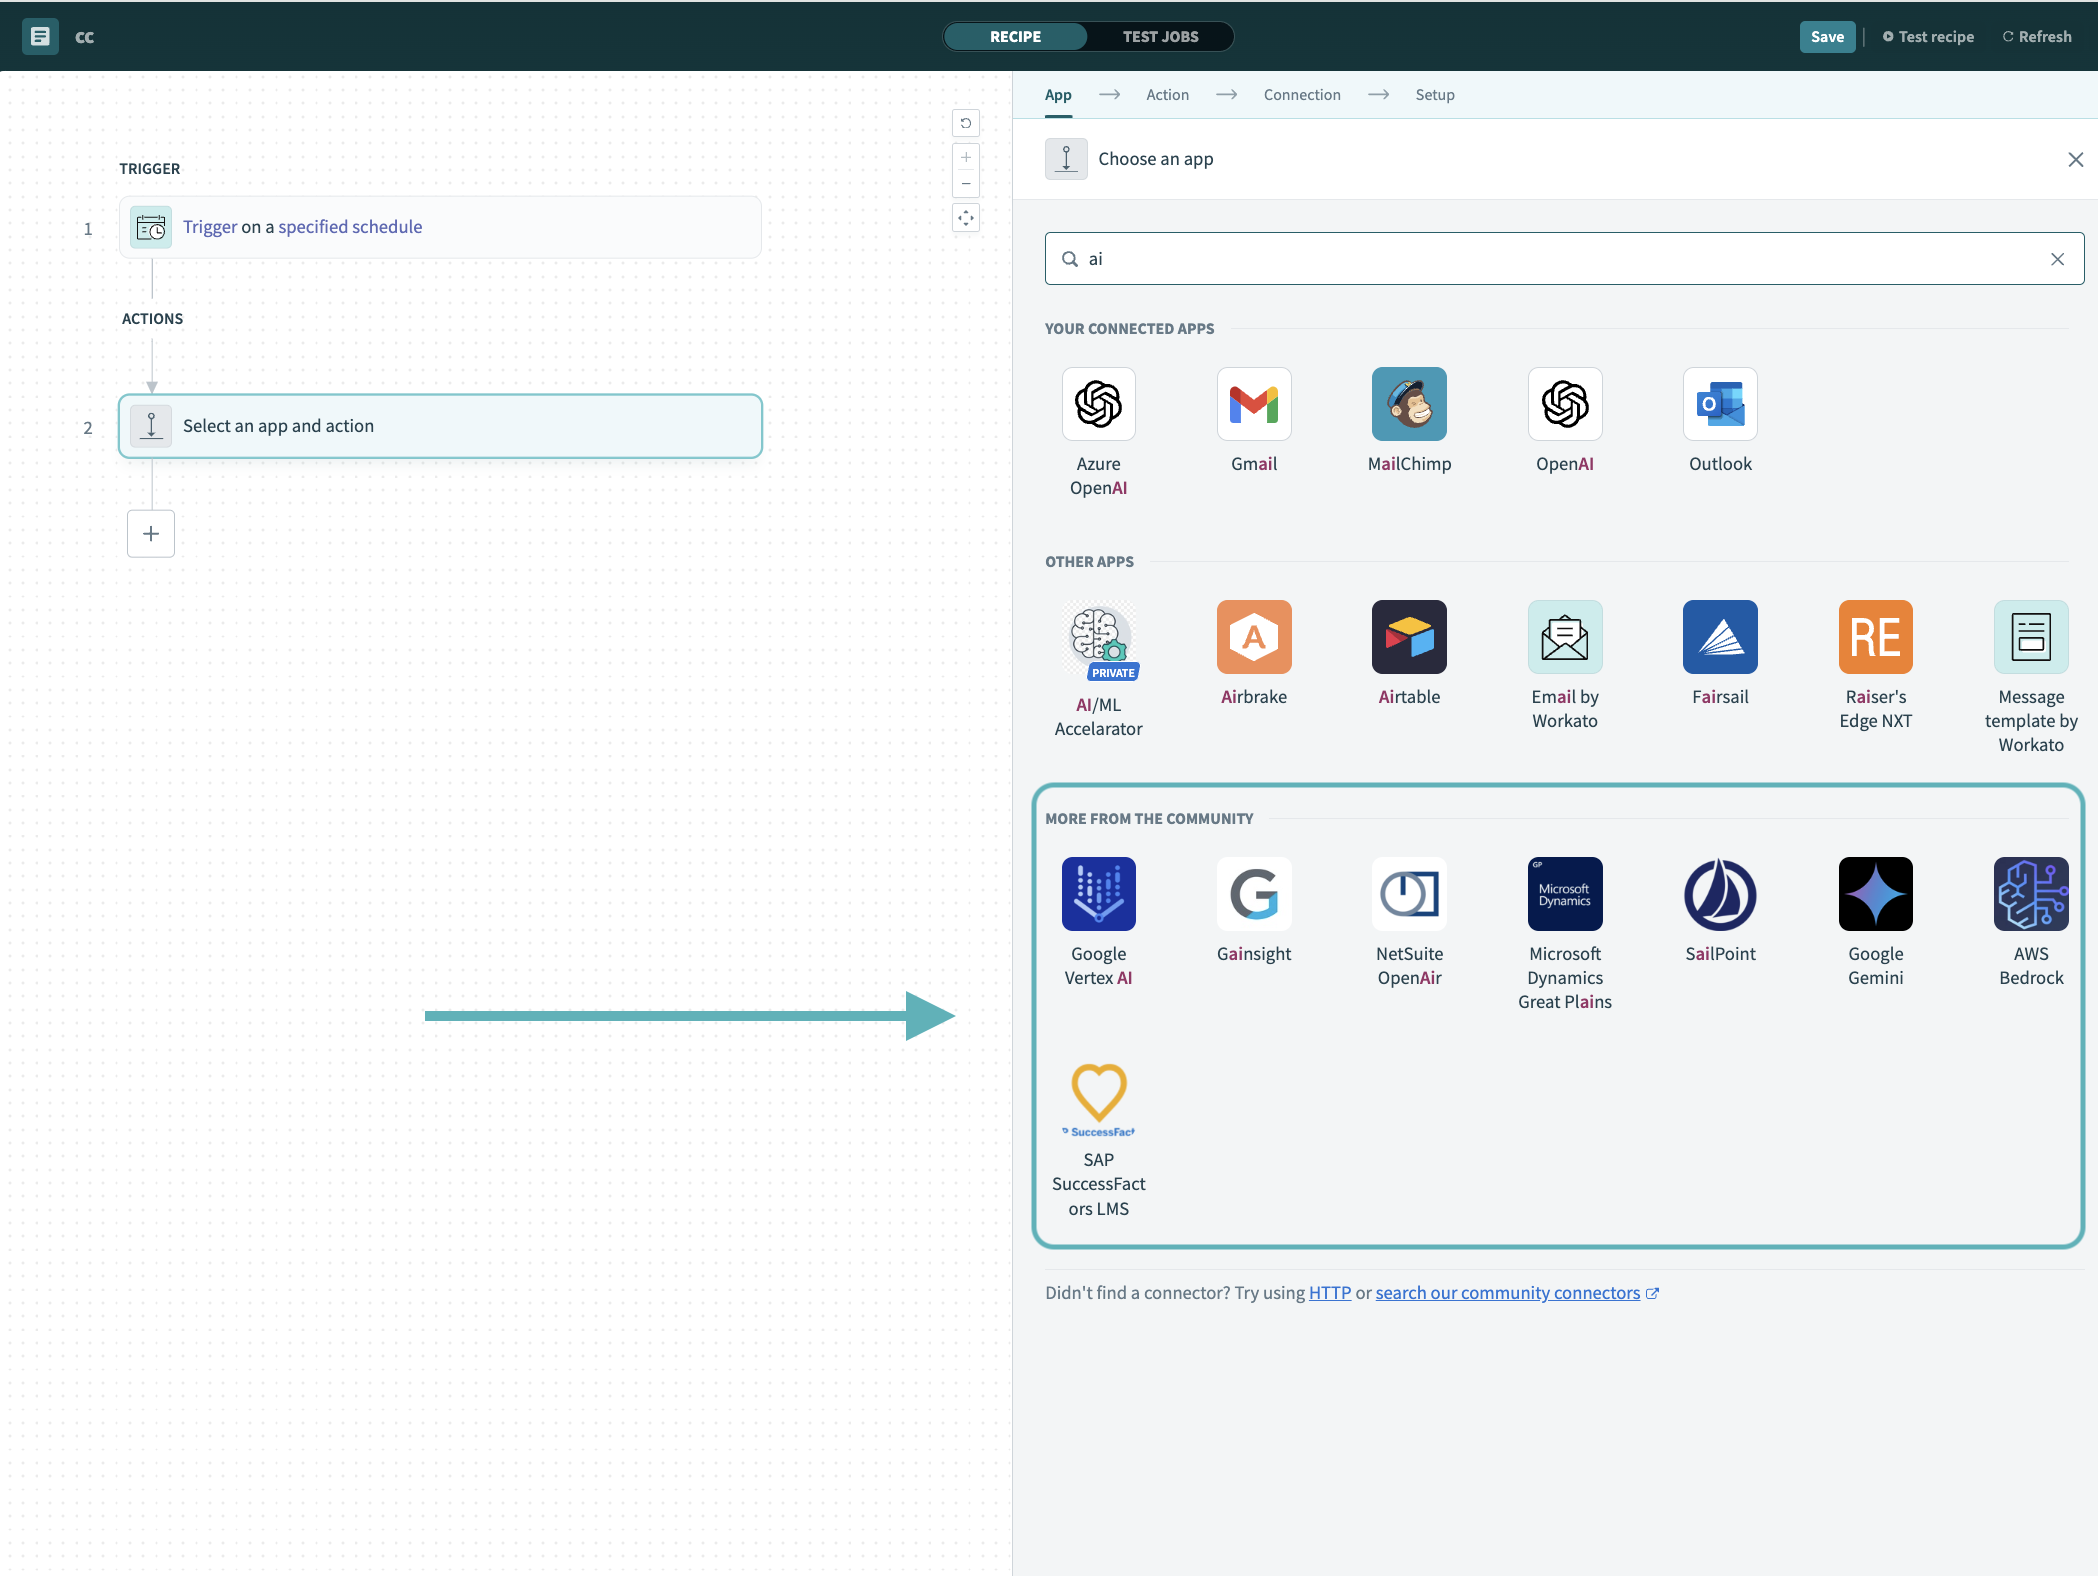 レシピエディターでコミュニティコネクターを検索
インストールするコミュニティコネクターを選択します。
インストールをクリックして、コミュニティライブラリからコネクターをインストールします。
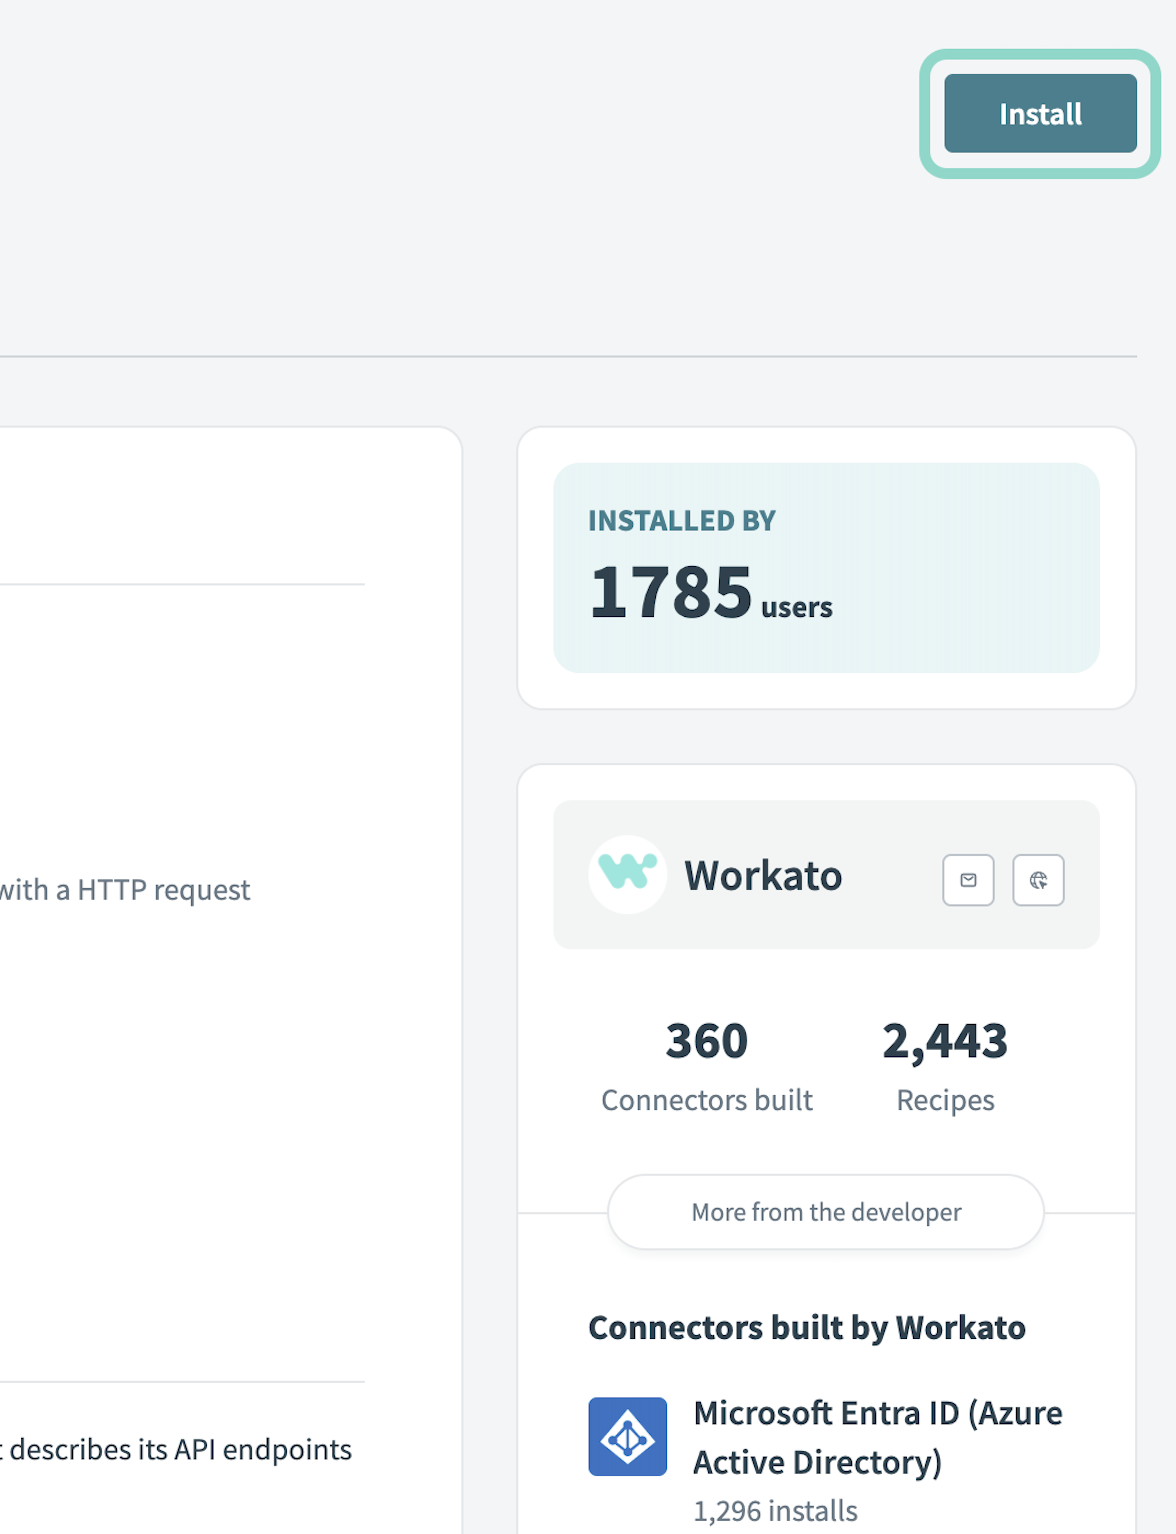 インストールをクリック
Release connector(コネクターをリリース)を選択します。または、ワークスペースにリリースする前にコネクターコードを確認して変更するには、コードを確認を選択します。
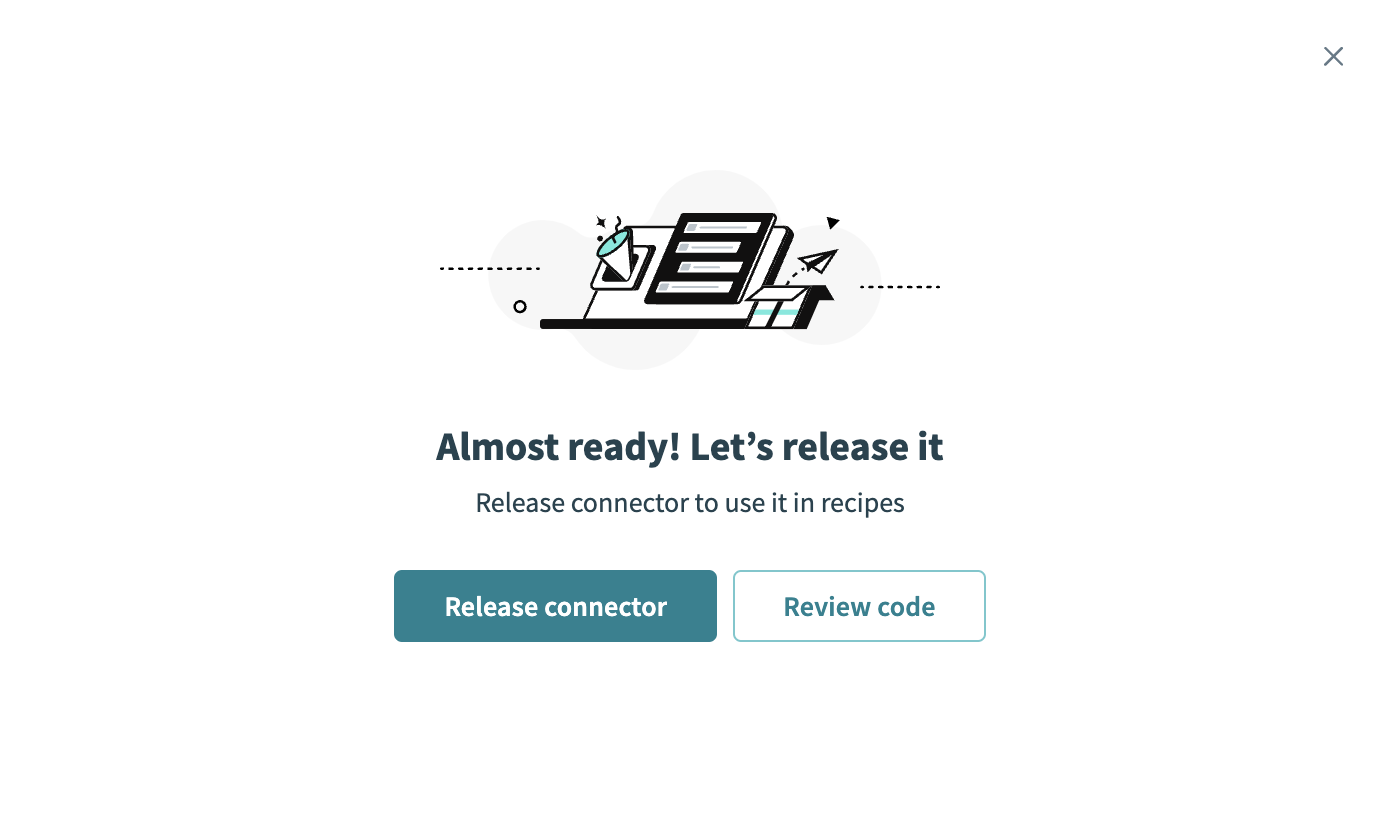 コネクターをリリース
コネクターに加えた変更を要約してから、リリースをクリックし、ワークスペースのコラボレーターがレシピでコネクターを使用できるようにします。
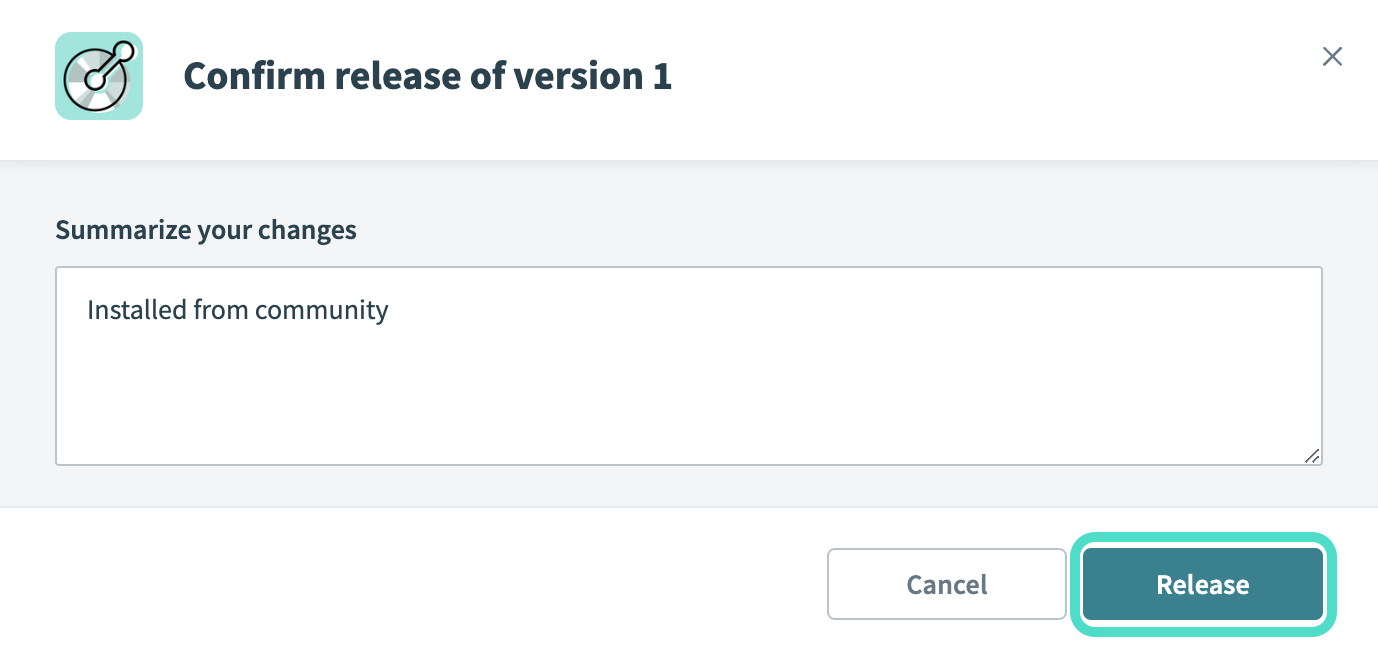 リリースの確認ダイアログ
コネクション設定
GCP BigLake Icebergコネクターは、Google CloudサービスアカウントとJWTベアラートークンによるカスタム認証を使用します。
最小スコープとデフォルトスコープ
Google Cloudサービスアカウントに次の最小権限を付与します。
biglake.tables.createbiglake.tables.getbiglake.tables.listbigquery.jobs.create- ウェアハウスバケットに対するストレージの読み取り/書き込みアクセス権。
サービスアカウントの詳細については、Google CloudのService accountsドキュメントを参照してください。
GCP BigLake Icebergのセットアップ
WorkatoでGCP BigLake Icebergへのコネクションを確立するためにGoogle Cloudサービスアカウントを作成するには、次の手順を実行します。
Google Cloudプロジェクトでサービスアカウントを作成し、そのJSONキーファイルをダウンロードします。詳細な手順については、Google CloudのCreate and delete service account keysドキュメントを参照してください。
Minimum and default scopesに記載されている権限をサービスアカウントに付与します。
プロジェクトでBigLake API(biglake.googleapis.com)とBigQuery API(bigquery.googleapis.com)を有効にします。完全な手順については、Google CloudのEnable and disable APIsドキュメントを参照してください。
カスタム認証を使用してGCP BigLake Icebergに接続
WorkatoでGCP BigLake Icebergに接続するには、次の手順を実行します。
作成 > コネクションをクリックします。
コネクションとしてGCP BigLake Icebergを検索して選択します。
コネクション名フィールドにコネクションの名前を入力します。
ロケーションドロップダウンメニューを使用して、コネクションを保存するプロジェクトを選択します。
作成したサービスアカウントのメールアドレスをService account emailフィールドに入力します。例:name@project.iam.gserviceaccount.com。
ダウンロードしたサービスアカウントJSONキーファイルから、BEGIN/END行を含む秘密鍵をコピーし、Private keyフィールドに貼り付けます。
リクエストに対して課金されるデフォルトのGoogle CloudプロジェクトIDをProject IDフィールドに入力します。例:my-gcp-project。
必要に応じて、BigLakeカタログとBigQueryジョブのデフォルトリージョンをDefault locationフィールドに入力します。例:us-central1またはUS。この値はアクションごとに上書きできます。
接続をクリックします。
最終更新日: