Greenhouseをデータパイプラインソースとして設定
Greenhouseをデータパイプラインソースとして設定し、応募、候補者、ジョブ、オファー、スコアカードなどの採用データをGreenhouse Harvest APIから抽出して、宛先に同期します。
このガイドを使用して、前提条件を確認し、Greenhouseをデータパイプラインソースとして接続し、パイプラインを設定して、サポートされているオブジェクト、同期モード、スキーマ処理、および制限事項について理解します。
サポートされている機能
Greenhouseをパイプラインソースとして使用する場合、次の機能がサポートされます。
- クラウド接続: https経由でGreenhouse Harvest APIに接続します。オンプレミスエージェントは不要です。
- カスタムドメイン: デフォルトの
https://harvest.greenhouse.ioに加えて、https://acme.greenhouse.ioなどのGreenhouseカスタムサブドメインをサポートします。 - オブジェクトレベルの選択: 宛先に同期するGreenhouseオブジェクトを選択します。
- 同期モード: オブジェクトごとに設定されるフル同期と増分同期をサポートします。
- カスタムフィールド: テナントのGreenhouseカスタムフィールドを検出し、それらをサポートするオブジェクト上の列として同期します。
- スキーマドリフト処理: ソーススキーマが変更されたときに、新しいフィールドを自動同期するか、新しいフィールドをブロックするかを選択します。
- フィールドレベルのデータ保護: 機密フィールドが宛先に到達する前にハッシュ化します。
- 設定可能な同期頻度: 時間ベースの間隔またはcron式を使用して同期をスケジュールします。
前提条件
Greenhouseをデータパイプラインソースとして接続する前に、次の要件を満たしてください。
- Harvest APIへのアクセス権を持つGreenhouseアカウント。
必要な権限
Greenhouseデータパイプラインはデータの読み取りのみを行います。コネクションを作成するときに、同期する予定のオブジェクトの読み取り(:list)スコープをリクエストするには、Harvest OAuthスコープフィールドを使用します。このフィールドを空白のままにすると、コネクションは書き込みスコープを含むデフォルトスコープをリクエストします。完全なリストについては、推奨スコープを参照してください。
推奨スコープ
特定のスコープを選択すると、harvest:users:listスコープは常に含まれます。
サポートされているGreenhouseオブジェクトを同期するには、Harvest OAuthスコープフィールドで次のHarvest API読み取りスコープを選択します。
Harvest API読み取りスコープ
harvest:applications:listharvest:application_stages:listharvest:approval_flows:listharvest:attachments:listharvest:candidate_educations:listharvest:candidate_employments:listharvest:candidate_tags:listharvest:candidates:listharvest:close_reasons:listharvest:custom_fields:listharvest:custom_field_options:listharvest:custom_field_departments:listharvest:custom_field_offices:listharvest:demographic_answer_options:listharvest:demographic_answers:listharvest:demographic_question_sets:listharvest:demographic_questions:listharvest:departments:listharvest:eeoc:listharvest:email_templates:listharvest:interviews:listharvest:job_hiring_managers:listharvest:job_interview_stages:listharvest:job_owners:listharvest:job_posts:listharvest:jobs:listharvest:notes:listharvest:offers:listharvest:offices:listharvest:openings:listharvest:prospect_pools:listharvest:referrers:listharvest:rejection_reasons:listharvest:scorecard_question_answers:listharvest:scorecards:listharvest:sources:listharvest:tracking_links:listharvest:user_emails:listharvest:user_job_permissions:listharvest:user_roles:listharvest:users:list
サポートされるコネクションタイプ
Greenhouseデータパイプラインは、Greenhouse Harvest v3 APIに対して認証を行うOAuth 2.0認可コードグラントをサポートしています。
Greenhouseデータパイプラインでは、APIキー認証はサポートされていません。
Greenhouseに接続
Greenhouseをデータパイプラインソースとして接続するには、次の手順を実行します。
Greenhouseに接続
Create > コネクションを選択します。
新規コネクションページでGreenhouseを検索し、選択します。
コネクション名フィールドに名前を入力します。
ロケーションドロップダウンメニューを使用して、コネクションを保存するプロジェクトを選択します。
任意です。組織でGreenhouseカスタムドメイン(acme.greenhouse.ioなど)を使用している場合は、そのドメインを入力します。このフィールドを空白のままにすると、コネクションはharvest.greenhouse.ioを使用します。
接続を選択し、Harvest OAuth資格情報を使用する権限を持つアカウントでGreenhouseにサインインします。コネクションが確立されると、Workatoに成功メッセージが表示されます。
パイプラインの設定
Greenhouseをデータパイプラインソースとして設定するには、次の手順を実行します。
作成 > データパイプラインを選択します。
データパイプライン名フィールドにデータパイプラインの名前を入力します。
ロケーションドロップダウンメニューを使用して、データパイプラインを保存するプロジェクトを選択します。
ビルドを開始をクリックします。
ソースアプリから新規/更新済みレコードを抽出トリガーをクリックします。このトリガーは、パイプラインがGreenhouseからデータを取得する方法を定義します。
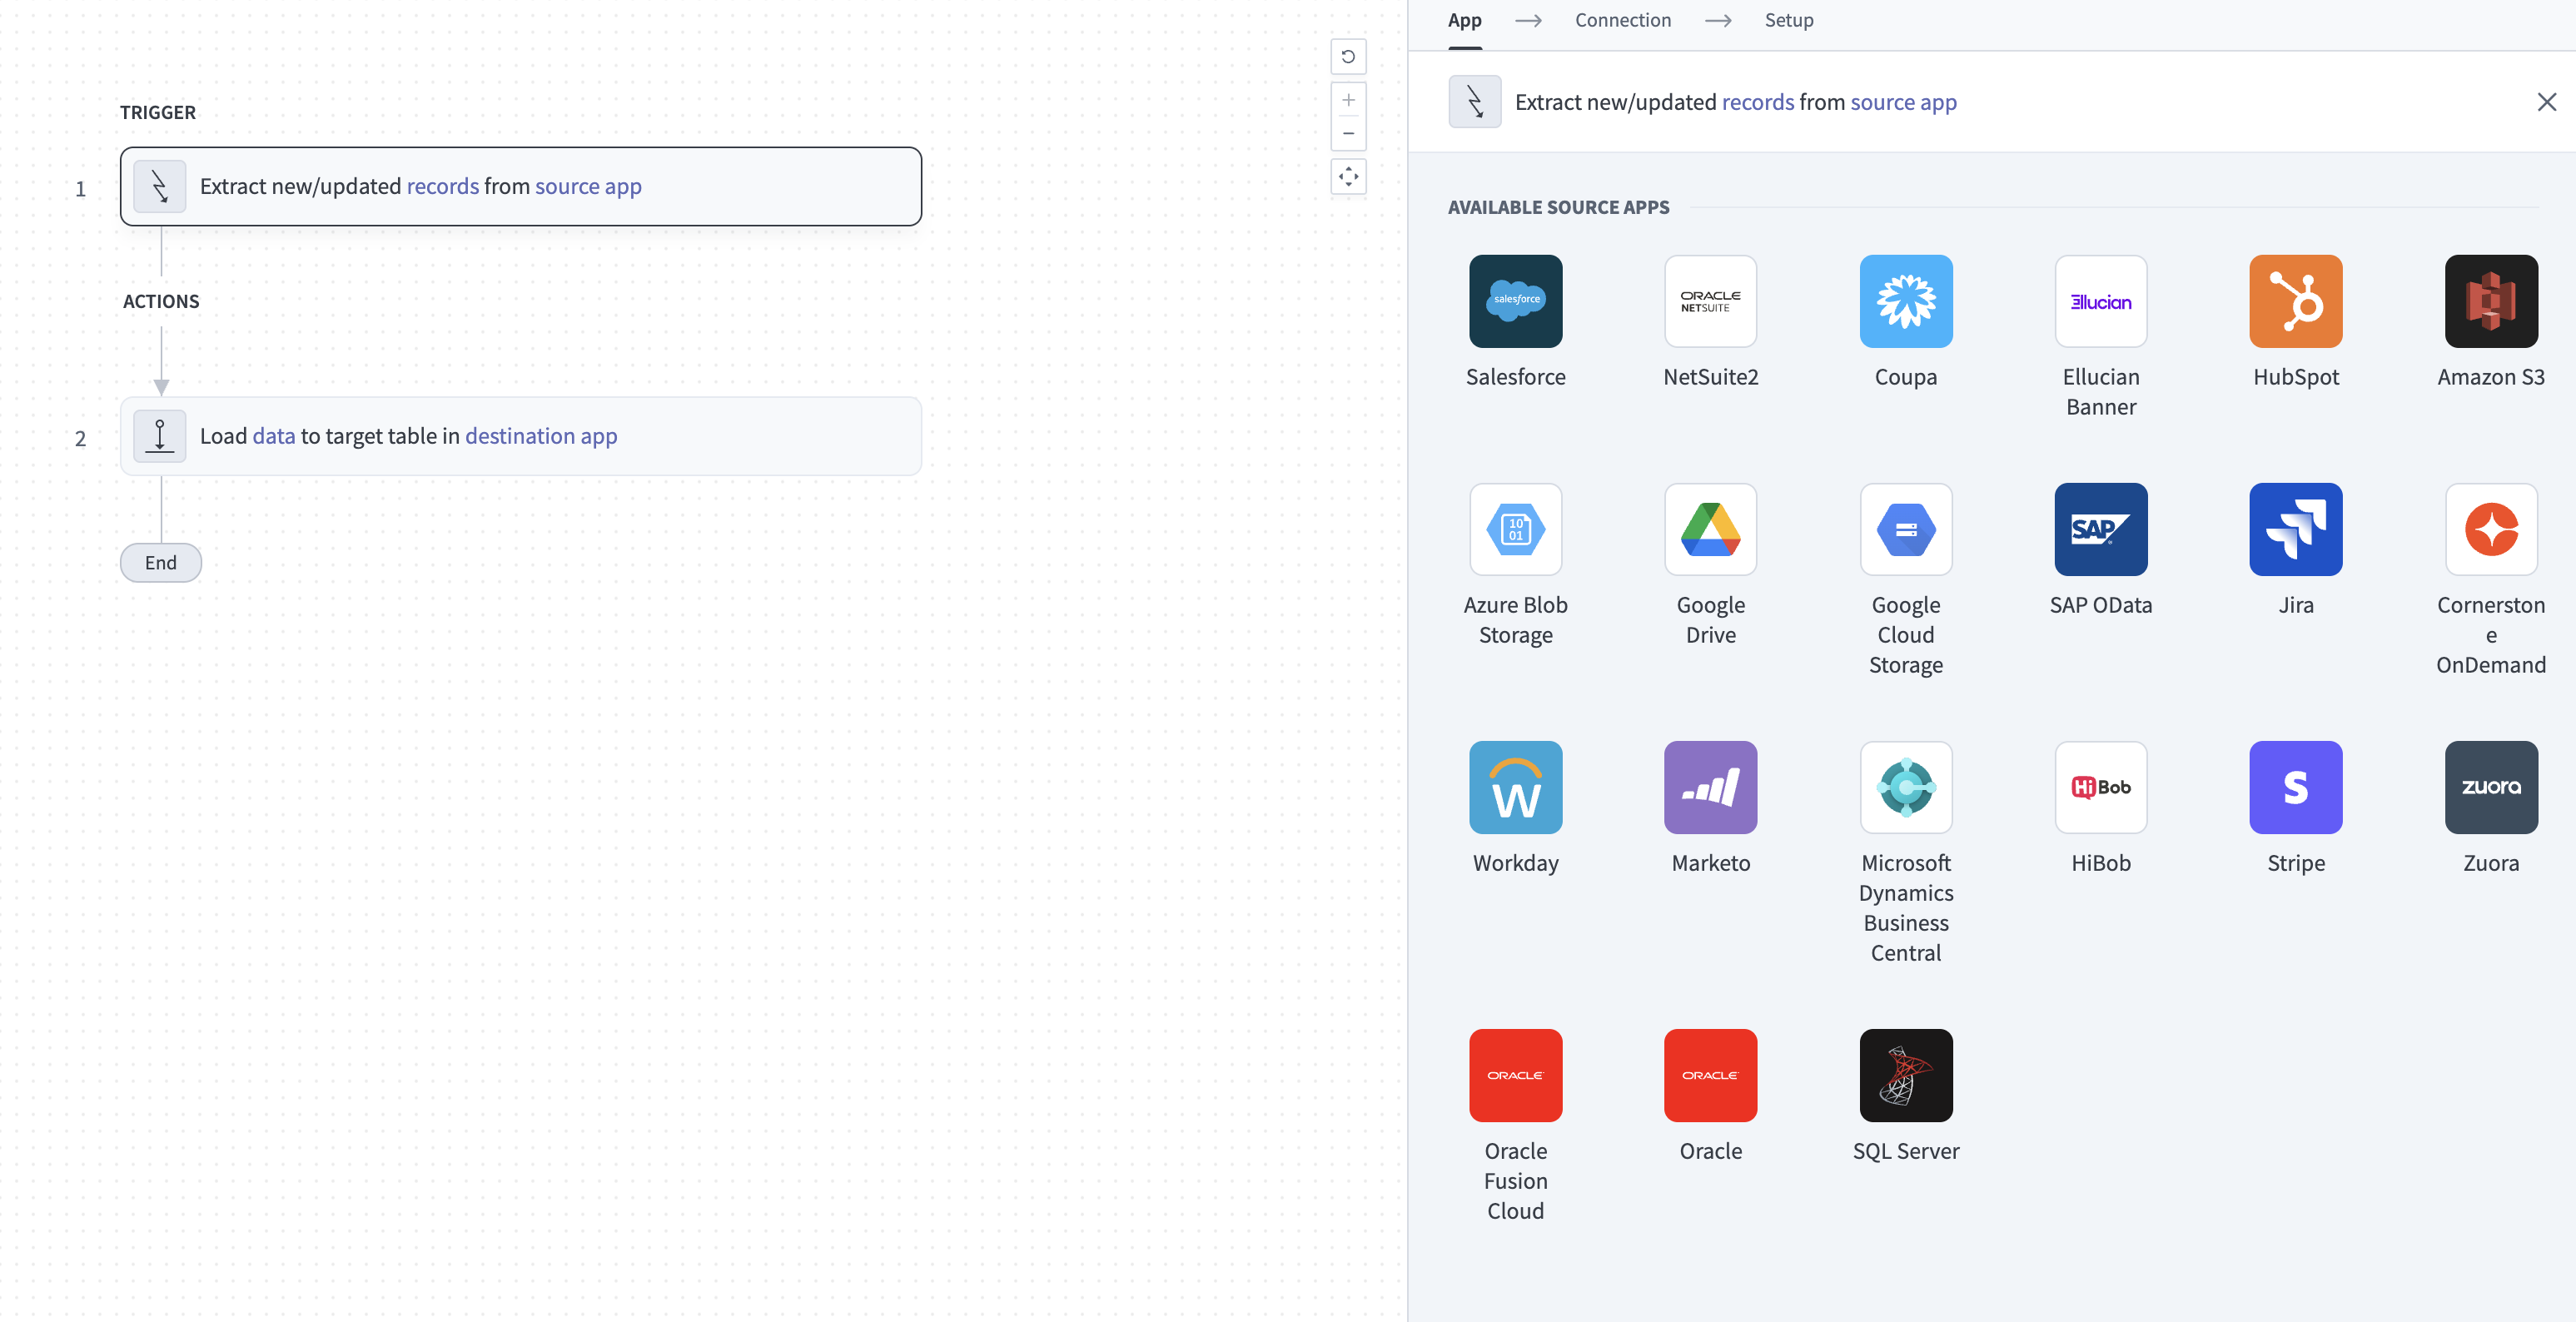 ソースアプリから新規/更新済みレコードを抽出トリガーを設定
接続済みソースアプリドロップダウンメニューを使用してGreenhouseを選択します。
このパイプラインで使用するGreenhouseコネクションを選択します。または、+ 新規コネクションをクリックして新しいコネクションを作成します。
オブジェクトを追加をクリックして、新しいオブジェクトを追加パネルを開きます。
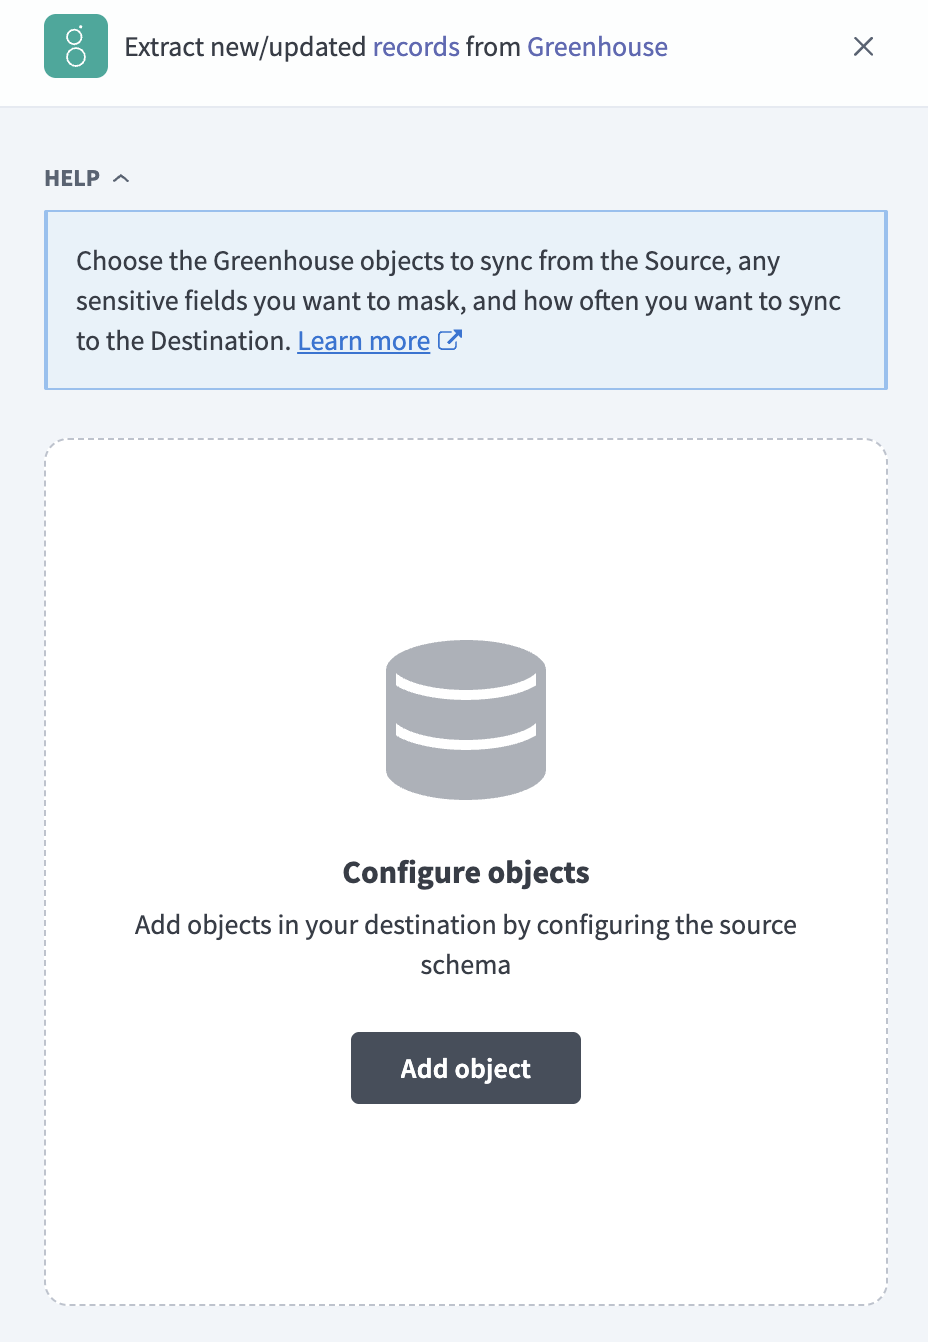 Greenhouseオブジェクトを追加
使用可能なGreenhouseオブジェクトのリストを検索または参照し、同期するオブジェクトを選択して、追加をクリックします。
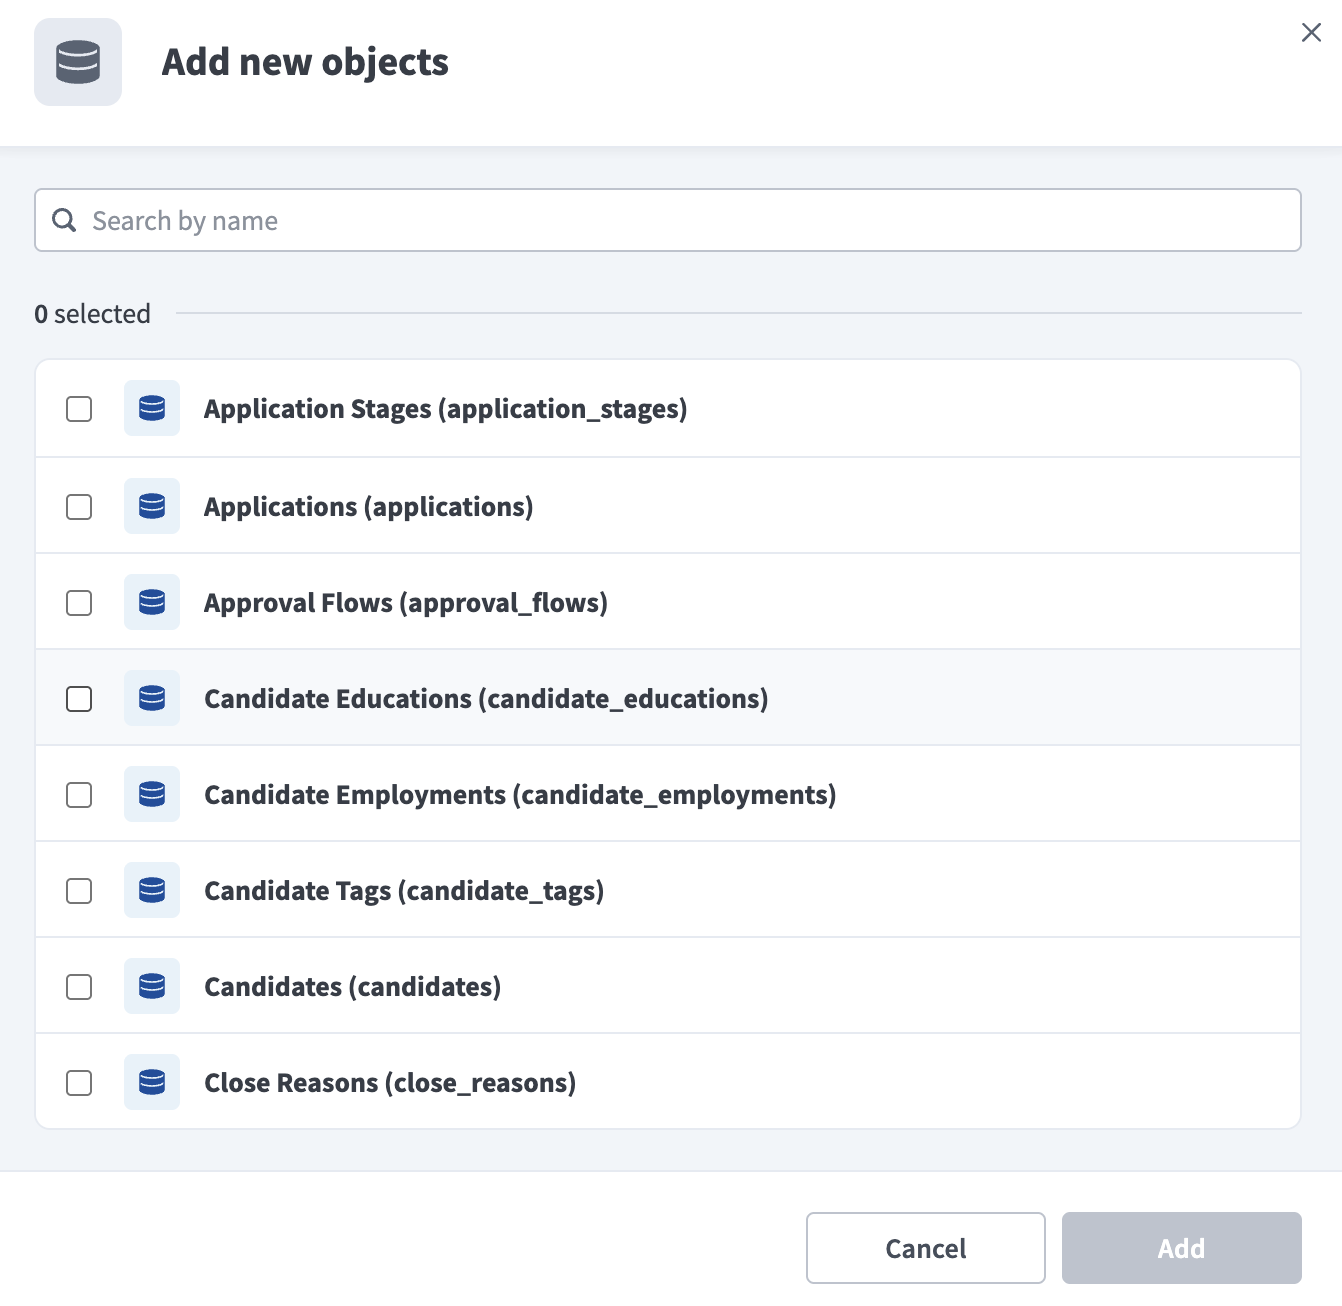 Greenhouseオブジェクトを選択
任意です。オブジェクトの同期方法を設定するには、オブジェクトの横にある設定アイコンをクリックします。同期モードドロップダウンメニューを使用して同期モードを選択します。 Greenhouseがオブジェクトのタイムスタンプを提供しない場合、そのオブジェクトのデフォルトはフル同期になります。詳細については、同期モードを参照してください。
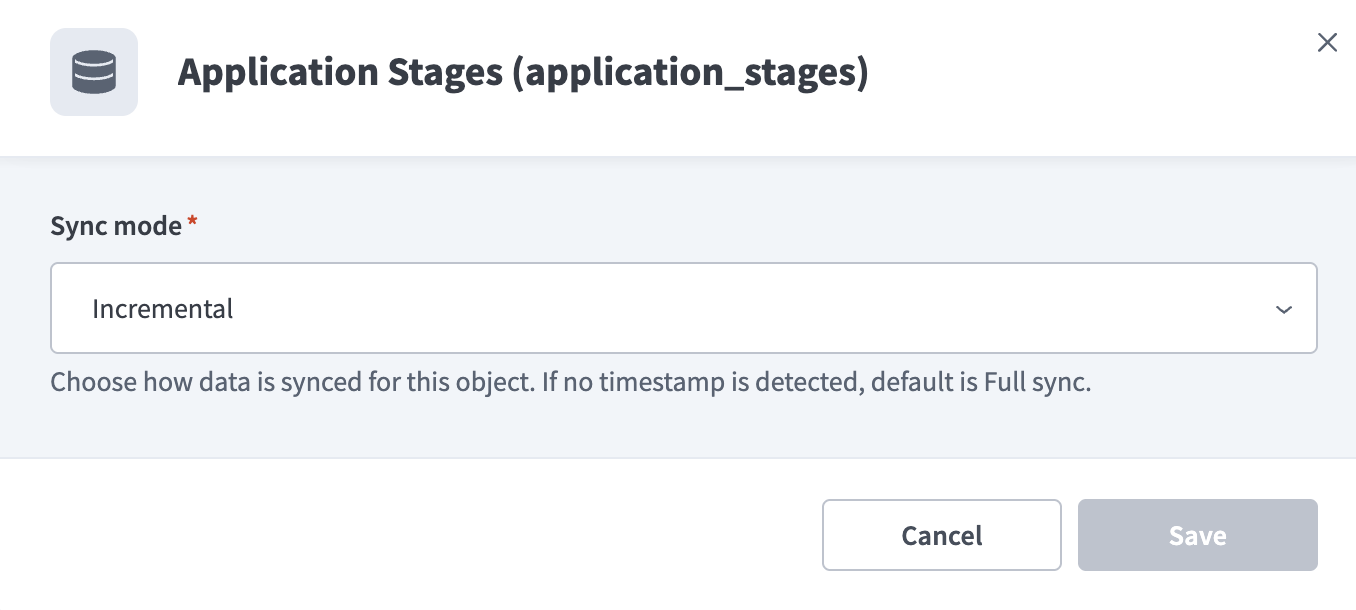 オブジェクトの同期モードを設定
選択した各オブジェクトのスキーマを確認してカスタマイズします。オブジェクトを選択すると、パイプラインはそのスキーマを自動的に取得し、宛先がソースと一致するようにします。
任意のオブジェクトを展開して、そのフィールドを表示します。使用可能なすべてのデータを抽出するにはすべてのフィールドを選択したままにし、データ抽出とスキーマレプリケーションから除外するには特定のフィールドの選択を解除します。
任意です。オブジェクトを展開し、各フィールドの処理方法を選択して、フィールドレベルのデータ保護を設定します。
- そのまま複製: ソースのデータ値が宛先に同一に複製されます。
- ハッシュ: 宛先に同期する前に、フィールド内の機密データ値をハッシュ化します。
Workatoでは、個人を特定できる情報(PII)やその他の機密フィールドをハッシュ化することを推奨します。 PIIが一般的に含まれるフィールドのリストについては、機密データの処理を参照してください。
さらにオブジェクトを追加するには、もう一度オブジェクトを追加をクリックします。この手順を繰り返して、パイプラインに追加のGreenhouseオブジェクトを含めます。
スキーマ変更の処理方法を選択ドロップダウンメニューを使用して、スキーマドリフトの処理オプションを選択します。
- 新しいフィールドを自動同期: ソースに追加された新しいフィールドを自動的に検出して同期します。
- 新しいフィールドをブロック: パイプラインの開始後、スキーマを固定します。新しいフィールドは手動で追加する必要があります。
Greenhouseテナントではカスタムフィールドが頻繁に追加されるため、Workatoでは新しいフィールドを自動同期することをお勧めします。
頻度フィールドで、パイプラインがGreenhouseから宛先にデータを同期する頻度を設定します。標準の時間ベースのスケジュールを選択するか、カスタムcron式を定義します。
サポートされるオブジェクト
Greenhouseデータパイプラインは、Greenhouse Harvest v3 APIリソースからデータを同期します。次の表は、サポートされているオブジェクトをカテゴリ別に示しています。各オブジェクトは、宛先内の個別のテーブルとして同期されます。
採用データ
| オブジェクト | 同期モード | 削除追跡 |
|---|---|---|
Application Stages | 完全同期、増分 | いいえ |
Applications | 完全同期、増分 | いいえ |
Approval Flows | 完全同期、増分 | いいえ |
Candidate Educations | 完全同期、増分 | いいえ |
Candidate Employments | 完全同期、増分 | いいえ |
Candidate Tags | 完全同期、増分 | いいえ |
Candidates | 完全同期、増分 | いいえ |
Interviews | 完全同期、増分 | いいえ |
Job Interview Stages | 完全同期、増分 | いいえ |
Job Posts | 完全同期、増分 | いいえ |
Jobs | 完全同期、増分 | いいえ |
Notes | 完全同期、増分 | いいえ |
Offers | 完全同期、増分 | いいえ |
Openings | 完全同期、増分 | いいえ |
Prospect Pools | 完全同期、増分 | いいえ |
Referrers | 完全同期、増分 | いいえ |
Scorecards | 完全同期、増分 | いいえ |
Tracking Links | 完全同期、増分 | いいえ |
ユーザーと組織
| オブジェクト | 同期モード | 削除追跡 |
|---|---|---|
Departments | 完全同期、増分 | いいえ |
Offices | 完全同期、増分 | いいえ |
User Job Permissions | 完全同期、増分 | いいえ |
User Roles | 完全同期、増分 | いいえ |
Users | 完全同期、増分 | いいえ |
設定データと参照データ
| オブジェクト | 同期モード | 削除追跡 |
|---|---|---|
Close Reasons | 完全同期、増分 | いいえ |
Custom Field Options | 完全同期、増分 | いいえ |
Custom Fields | 完全同期、増分 | いいえ |
Email Templates | 完全同期、増分 | いいえ |
Rejection Reasons | 完全同期、増分 | いいえ |
Sources | 完全同期、増分 | いいえ |
人口統計およびEEOCデータ
EEOCオブジェクトとDemographic Answersオブジェクトには、保護対象クラスのデータが含まれています。これらのオブジェクトはデフォルトで同期から除外され、新しいオブジェクトを追加パネルには表示されません。
| オブジェクト | 同期モード | 削除追跡 |
|---|---|---|
Demographic Answer Options | Full sync | いいえ |
Demographic Answers | 完全同期、増分 | いいえ |
Demographic Question Sets | 完全同期、増分 | いいえ |
Demographic Questions | Full sync | いいえ |
EEOC | 完全同期、増分 | いいえ |
同期モード
Greenhouseデータパイプラインは、フル同期と増分同期をサポートしています。同期モードは、オブジェクトをパイプラインに追加するときにオブジェクトごとに設定されます。
フル同期
フル同期では、同期のたびにGreenhouseから使用可能なすべてのレコードを読み取り、宛先テーブルを上書きします。宛先テーブルはソースの現在の完全な状態を反映するため、Greenhouseで削除されたレコードは次回の同期時に宛先から削除されます。
増分同期
増分同期では、前回の同期後に作成または更新されたレコードのみを読み取ります。パイプラインは各レコードのupdated_atタイムスタンプを追跡し、前回の実行時の最新タイムスタンプより後に更新されたレコードのみをリクエストします。 updated_atタイムスタンプを提供しないオブジェクトは、フル同期で同期されます。
増分同期では、Greenhouseで削除されたレコードはキャプチャされません。削除されたレコードは宛先テーブルに残ります。
削除追跡
Greenhouse Harvest v3 APIは削除フィードを提供しないため、Greenhouseデータパイプラインは削除を追跡しません。宛先から削除済みレコードを削除するには、オブジェクトをフル同期で同期します。
スキーマとデータ型の処理
カスタムフィールド
Greenhouseデータパイプラインは、テナントのカスタムフィールドを検出し、カスタムフィールドをサポートするオブジェクト(Jobs、Applications、Candidates、Offers、Openings)に列として追加します。カスタムフィールド列には、フィールドのGreenhouse name_key値に基づいて名前が付けられます。
Greenhouseは、短いテキスト、長いテキスト、はい/いいえ、単一選択、複数選択、日付、URL、通貨、数値、ユーザーのカスタムフィールドタイプをサポートしています。
ネストされたオブジェクトと配列
ネストされたオブジェクトまたは配列を含むフィールドは、JSON文字列として宛先に同期されます。
タイムスタンプ
Greenhouseのタイムスタンプは、2024-01-15T10:30:00.000ZなどのISO 8601 UTC文字列です。一部のフィールドは、Offersオブジェクトのsent_onフィールドなど、YYYY-MM-DD形式の日付のみの値を返します。パイプラインは元の値を保持します。
機密データの処理
Greenhouseオブジェクトには大量の個人を特定できる情報(PII)が含まれており、一部のオブジェクトには保護対象クラスのデータまたは報酬データが含まれています。次のオブジェクトには、一般的に機密フィールドが含まれます:
| オブジェクト | 機密フィールド |
|---|---|
Candidates | first_name, last_name, phone_numbers, email_addresses, addresses, social_media_addresses, photo_url |
Candidate Educations | 学歴 |
Candidate Employments | 職歴 |
Applications | answers(自由テキストの回答)、cover_letter_text |
Users | name, first_name, last_name, primary_email_address, emails, employee_id |
Offers | custom_fields(給与および報酬データを含むことが多い) |
Scorecards | notes(自由テキストの面接担当者評価) |
Notes | 自由テキストのメモ内容 |
Interviews | organizer、interviewers(社内従業員のPII) |
EEOC | gender, race, disability_status, veteran_status(保護対象クラスのデータ) |
Demographic Answers | free_form_text(保護対象クラスのデータ) |
PIIが送信先に到達する前に保護するには、パイプライン設定中にフィールドレベルのデータ保護でHashオプションを使用します。詳細については、パイプラインを構成手順を参照してください。報酬データが保護されていない状態で宛先に到達しないように、WorkatoではOffersオブジェクトのcustom_fieldsフィールドをハッシュ化することをお勧めします。
候補者の匿名化
候補者が匿名化されると(たとえば、GDPRまたはCCPAの消去リクエスト後)、Greenhouseは候補者のanonymized_atタイムスタンプを設定し、候補者のPIIフィールドをクリアします。パイプラインは、宛先でanonymized_at値を保持します。匿名化された候補者レコードはnullのPIIフィールドで同期されます。これは想定される動作です。
制限事項
Greenhouseをデータパイプラインソースとして使用する場合、次の制限事項が適用されます。
非公開候補者
Greenhouseは、表示する権限のないAPIユーザーに非公開候補者を返しません。パイプラインは、同期から欠落している非公開候補者を検出したり警告したりすることはできません。宛先に非公開候補者がない場合は、コネクションを認可したGreenhouseアカウントの権限を確認してください。
機密ジョブ
Greenhouseで機密としてマークされたジョブは、コネクションを認可したアカウントの権限によっては、nameやrequisition_idなどのフィールドにnull値を返す場合があります。パイプラインは、これらのレコードをnull値で同期し、confidentialフィールドを保持します。
最小同期頻度
サポートされる最小同期間隔は15分です。これより高い頻度で同期をトリガーすることはできません。
最終更新日: