変換マップの例
次の例は、一般的な連携パターンの完全な変換マップを示しています。欠落フィールドが含まれる可能性のあるプロダクションデータには、これらの例にnull処理を追加してください。
- Reshape a list: リスト内の項目の形を変更します。
- Aggregate with group-by: リストをキーでグループ化し、各行をコピーする代わりに、各グループの件数または合計を計算します。
- Chain a transformation with filter and sort: 複数ステージの変換を個別のノードに分割します。
- Flatten a nested array: 別の配列の内側に入れ子になった配列の各要素ごとに行を生成します。
- Join two arrays: 共通のキーに基づいて配列同士を関連付けます。
リストの整形
受信システムがある形の項目リストを送信し、ターゲットシステムが別の形、例えばフィールド名の違いや計算値を含む形で各項目を必要とする場合に、このパターンを使用します。
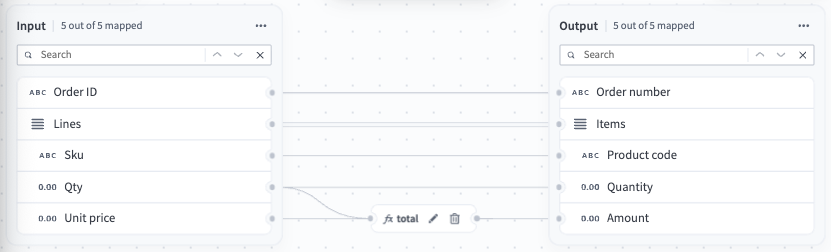
この例では、eコマース注文webhookがsku、qty、unit_priceを含む注文行を送信します。 ERPでは、product_code、quantity、行ごとのamountを含む項目が必要です。
 リストの整形
この整形では、リスト全体に対するFormulaは必要ありません。 order_id、sku、qty は新しい名前の下でそのまま渡されるため、Formulaが必要なのは計算された amount フィールドだけです。
totalノードは、数量に単価を掛けて、行ごとの合計を生成します。単一のスカラー値を返すため、ノードに出力スキーマは必要ありません。 IntegerにNumberを掛けると、Numberが返されます。
group-byによる集計
行単位のコピーではなくサマリーが必要な場合に、このパターンを使用します。たとえば、リストをキーでグループ化し、各グループの件数または合計を計算する場合です。
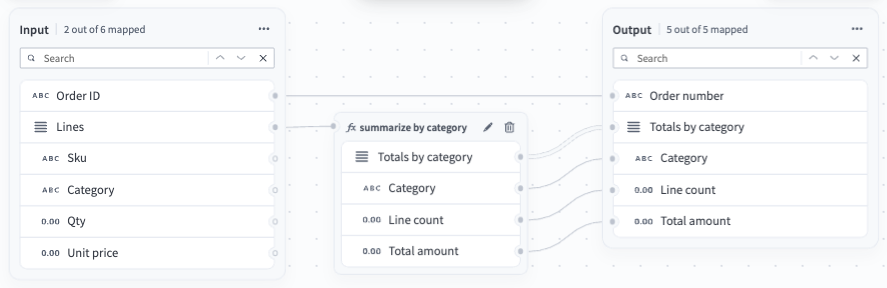
この例では、同じ注文行にcategoryが含まれています。ターゲットでは、カテゴリごとに行数と合計金額を含む1行が必要です。
 group-byによる集計
order_idは、1対1の名前変更と同様に、変更されずにorder_numberに直接接続されます。集計に必要なフィールドはlinesだけであるため、linesだけがsummarize by categoryノードに送られます。
summarize by categoryノードは、3つのステージで集計を実行します。 group_byは、カテゴリごとに行を1つのバケットに収集します。これにより、リストではなくマップが生成されます。 entriesは、そのマップをキーと値のペアのリストとして再表現し、反復処理できるようにします。その後、map_byは各ペアに対して1つのオブジェクトを返します。このオブジェクトには、カテゴリ名、グループ内の行数、行合計の合計が含まれます。
ノードはオブジェクトのリストを返すため、出力スキーマが必要です。 When to define an output schemaを参照してください。
フィルターとソートを使用した変換のチェーン
変換を複数のステージで実行する場合に、このパターンを使用します。チェーンにより、各ステージが独自のノードに保持されるため、キャンバスから変換を読み取り、各ステージを個別にテストできます。
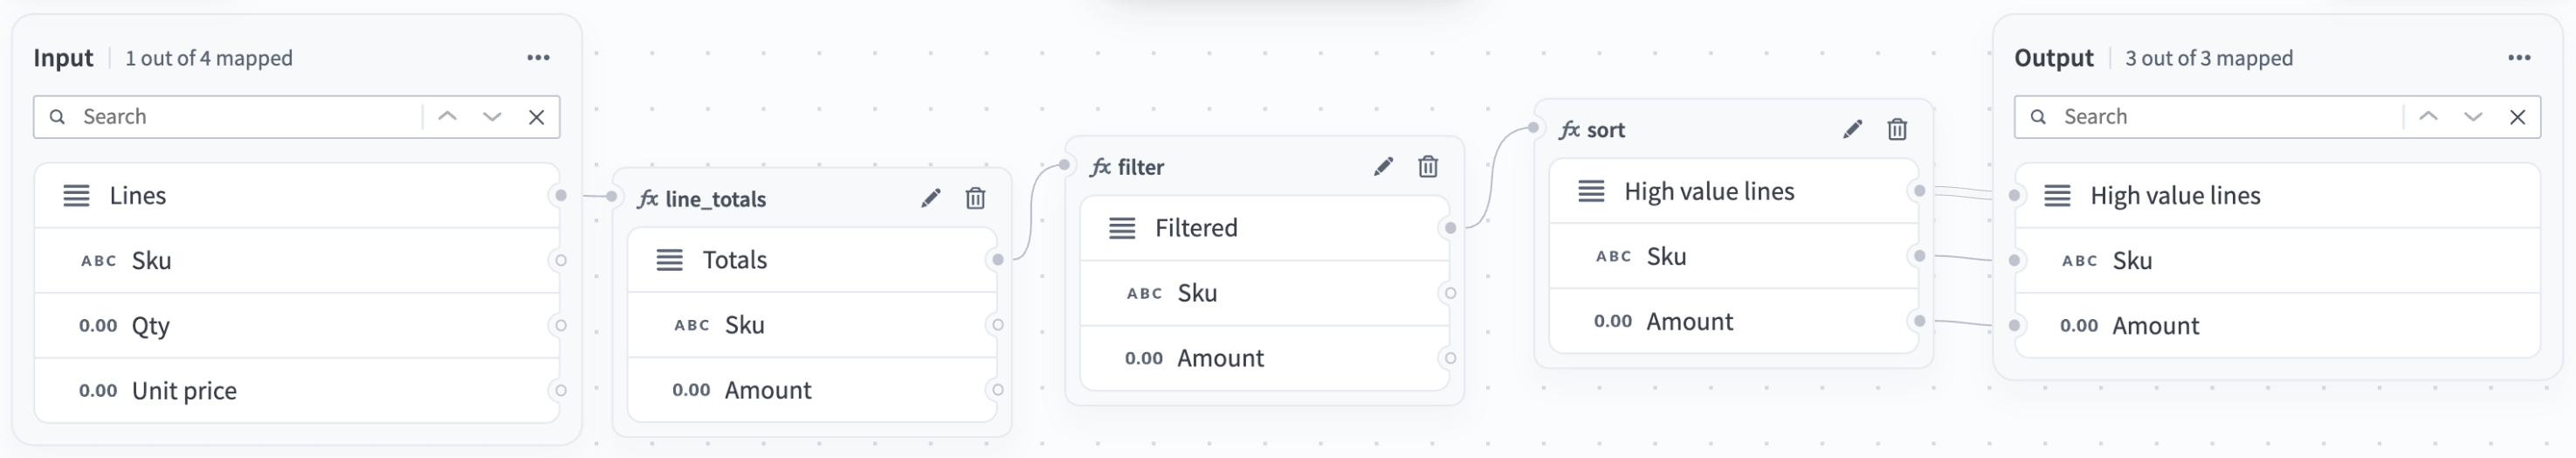
この例では、注文行にsku、qty、unit_priceが含まれています。マップは行ごとの合計を計算し、しきい値を下回る行を除外し、残った行を合計でソートします。各ステージは独自のノードにあります。
 フィルターとソートを使用した変換のチェーン
マップは3つのノードを使用し、それぞれが1つのステージを処理します。
line_totalsは、qtyにunit_priceを掛けて行ごとの合計を計算します。filterは、合計が20以上の行のみを保持します。sortは、残りの行を合計の高い順から低い順に並べ替えます。
各ノードは、_.line_totals_linesや_.filter_filteredのように、上流のFormula名を使って直前のノードの出力を参照します。チェーン内のすべてのノードはリストを返すため、それぞれに独自の出力スキーマが必要です。 When to define an output schemaを参照してください。
4行から4つの合計が生成され、フィルターによって19のA-100が削除され、ソートによって120のD-410が45のC-050と40のB-220より前に配置されます。
3つのステージすべてを1つのノード内の単一のFormulaとして記述できます。これにより同じ結果が生成され、必要な出力スキーマは1つだけです。各Stageを個別にテストする、あるいは単一のFormulaが読みづらくなった場合は、各Stageをチェーンしてそれぞれを分けて実装します。
ネストされた配列のフラット化
必要な値が別の配列内にネストされた配列にある場合に、このパターンを使用します。内側の配列には直接アクセスできないため、変換はトップレベルの配列から開始し、内側の要素に向かってフラット化していきます。詳細についてはArraysを参照してください。
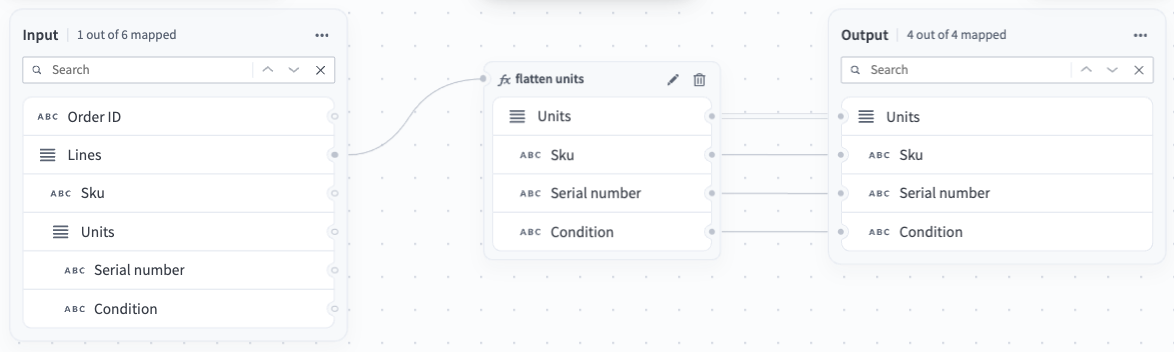
この例では、linesはオブジェクトのリストであり、各行には独自のオブジェクトのunitsリストがあります。ターゲットでは、各ユニットに対して、そのユニットの元となった行のskuを含む1行が必要です。
 ネストされた配列のフラット化
flatten unitsノードは各行をたどり、その行のunitsリストをたどって、結果を単一のリストにフラット化します。合計3つのユニットを含む2行から、3行が生成されます。
Formulaは各ユニットを処理している間に親行からskuを読み取ります。これにより、すべての行が元の行から値を保持します。これがない場合でもノードはフラット化しますが、結果にはユニットフィールドのみが含まれ、各ユニットがどの行から来たかを示す情報は含まれません。
ノードはオブジェクトのリストを返すため、出力スキーマが必要です。 When to define an output schemaを参照してください。
2つの配列の結合
ペイロードに、注文行と製品カタログなど、共有キーで関連付ける必要がある2つのリストが含まれている場合に、このパターンを使用します。
この例では、linesにはskuと数量が含まれ、productsには各skuの名前と価格が含まれます。ターゲットでは、各行に対して1つのエンリッチされた項目が必要です。
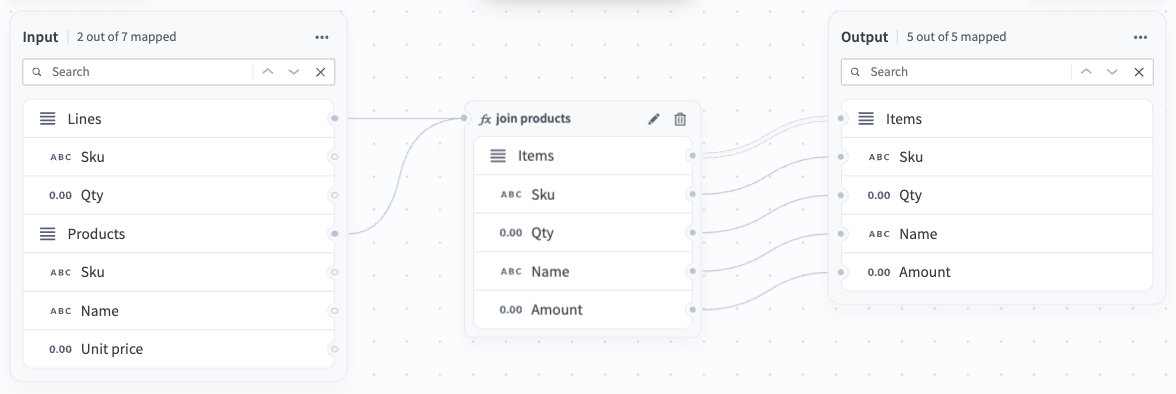 2つの配列の結合
join productsノードは、行を処理する前に、skuをキーとしてproductsからルックアップを一度構築します。その後、各行は、行ごとに製品リストを再検索するのではなく、そのルックアップから製品を直接読み取ります。ノードは各行に対して1つの項目を返し、行の数量と一致した製品の名前、およびその価格から計算された金額を組み合わせます。
ノードはオブジェクトのリストを返すため、出力スキーマが必要です。 When to define an output schemaを参照してください。
lines 内のすべての sku は products 内に存在している必要があります。存在しないキーを参照して検索するとマッピングは Cannot access field エラーで失敗するため、ソースデータにキーが一致しないレコードを含む可能性がある場合はフォールバック処理を追加してください。 productsに同じskuが複数回含まれる場合、ルックアップはそのキーの最後のエントリを保持し、それ以前のエントリを破棄します。
最終更新日: