Google BigQuery MCPサーバー
Google BigQuery MCPサーバーを使用すると、LLMは自然な会話を通じて、分析およびデータウェアハウス操作のためにGoogle BigQueryと連携できます。データセットとテーブルの検出、実行前のクエリコストの見積もり、パラメーター化されたSQLクエリの実行、データ変更の実行、行のストリーミング、ジョブの監視を行うためのツールを提供し、Google BigQueryコンソールを直接操作する必要はありません。
用途
Google BigQuery MCPサーバーを使用して、次のアクションを実行します:
- BigQueryプロジェクト内のデータセット、テーブル、およびそれらのスキーマを検出
- クエリコストなしでテーブル行をプレビューしてデータをサンプリング
- 高コストなスキャンを実行する前にドライランでクエリコストを見積もり
- 使用額上限付きでパラメーター化された読み取り専用GoogleSQL SELECTクエリを実行
- 長時間実行クエリのポーリングと大規模な結果のページ分割により、完全な結果セットを取得
- データを変更するSQLステートメントを実行
- DDLを使用してデータセット、テーブル、ビューを作成、変更、削除
- 行ごとのエラーレポート付きでJSON行をテーブルにストリーミング
- クエリおよびDMLジョブの進行状況を監視し、実行統計を取得
- ベストエフォート方式で実行中のジョブをキャンセル
プロンプト例
次のプロンプト例を使用して、Google BigQuery MCPサーバーツールを呼び出します:
What datasets are available in the analytics project?Show me the schema and row count for the customers table in my analytics dataset.Preview the first 10 rows of the events table to see what data is available.How many bytes would scanning all columns from the large_transactions table cost?Run a query to find the top 10 customers by revenue from the last quarter.What are the results of the query with job ID xyz123 in the US region?Update all records in the test_table where status equals pending to status equals completed.Stream 100 new event rows into the events table and report any failures.What is the status of my long-running data load job?Cancel the query job that's been running for too long.
Google BigQuery MCPサーバーツール
Google BigQuery MCPサーバーは次のツールを提供します:
| ツール | 説明 |
|---|---|
| list_datasets | BigQueryプロジェクト内のデータセットを一覧表示します。 |
| get_dataset | 特定のデータセットのメタデータを取得します。 |
| list_tables | データセット内のテーブル、ビュー、および外部テーブルを一覧表示します。 |
| get_table | テーブルのスキーマとメタデータを取得します。 |
| preview_table_rows | クエリを実行したりクエリコストを発生させたりせずに、サンプル行をテーブルから直接読み取ります。 |
| estimate_query_cost | SQLステートメントを検証し、実行したりコストを発生させたりせずにスキャンされるバイト数を見積もります。 |
| run_query | 読み取り専用のGoogleSQL SELECTクエリを実行し、行またはジョブ参照を返します。 |
| get_query_results | クエリジョブをポーリングし、ジョブIDに基づいてページ分割された結果行を取得します。 |
| execute_sql | 許可リストに含まれるデータまたはスキーマを変更する単一のSQLステートメント(DMLまたはDDL)を実行します。 |
| insert_rows | JSON行をBigQueryテーブルにストリーミングします。 |
| get_job | BigQueryジョブのステータス、統計、およびエラーを取得します。 |
| cancel_job | 実行中のBigQueryジョブのベストエフォート方式のキャンセルをリクエストします。 |
Google BigQuery MCPサーバーのインストール
構築済みMCPサーバーをプロジェクトにインストールするには、次の手順を完了します:
Workatoアカウントにサインインします。
AI Hub > Enterprise MCPに移動します。
+ Create MCP serverをクリックします。
接続済みアプリを使用して構築済みMCPサーバーを開始するセクションに移動し、使用する構築済みMCPサーバーを選択します。
Use this serverをクリックします。
サーバー名フィールドにMCPサーバーの名前を入力します。
場所ドロップダウンメニューを使用して、MCPサーバーのプロジェクトを選択します。
Connectionsセクションに移動し、アプリアカウントに接続します。
MCPサーバーテンプレートで使用するコネクションタイプを選択します。
- User's connection: MCPサーバーツールは、アプリケーションに接続するユーザーのIDと権限に基づいてアクションを実行します。ユーザーは自分の認証情報で認証し、スキルを実行します。
- Your connection: このオプションでは、レシピビルダーによって確立されたコネクションを使用し、通常のアプリコネクションと同じ原則に従います。
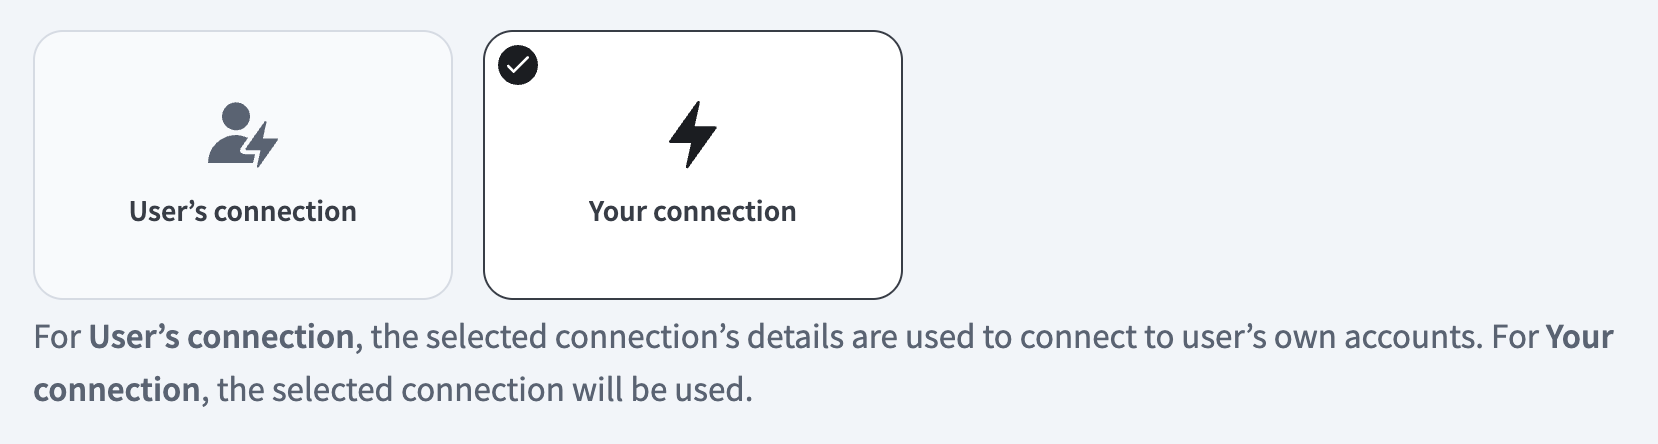 コネクションタイプを選択
検証済みユーザーアクセスの認証要件
OAuth 2.0認可コードグラントを使用するアプリコネクションのみが、ユーザーのコネクションで利用できます。詳細については、検証済みユーザーアクセスを参照してください。
次のセクションで、アプリ固有のコネクション設定手順を完了します。
Google BigQueryコネクション設定
Google BigQueryコネクション設定手順を表示
APIバージョン
Google BigQueryコネクターはGoogle BigQuery API v2を使用します。
Google BigQueryへの接続方法
Google BigQueryへの接続手順を表示
Google BigQueryコネクターは、次の認証方法をサポートしています。
- OAuth 2.0
- サービスアカウント
サービスアカウント認証用のGoogle BigQuery設定
Googleサービスアカウントは、Google Cloudプロジェクト(GCP)に関連付けられた専用のGoogleアカウントであり、ユーザーに代わってAPIリクエストを実行できます。
サービスアカウントには次の利点があります:
- 継続的な運用: サービスアカウントにより、個々のユーザー権限が変更された場合でも運用を継続できます。
- 専用の権限: サービスアカウントは、共有先として指定したプロジェクトにのみアクセスできます。
- 専用のAPIクォータ: GCPを通じてサービスアカウントのAPIクォータを管理し、Googleに直接クォータの引き上げをリクエストできます。
サービスアカウントの詳細については、Googleサービスアカウントのドキュメントを参照してください。
サービスアカウント認証で接続する前に、Googleサービスアカウントを作成し、そのメールアドレスと秘密鍵を記録しておく必要があります。
Googleサービスアカウントの設定
Google service accountをセットアップする手順を表示
Googleサービスアカウントを設定するには、次の手順を実行します:
GCPプロジェクトでサービスアカウントを作成します。
IAMと管理>サービスアカウントに移動します。ダッシュボードのスコープが、サービスアカウントを含むプロジェクトに設定されていることを確認します。
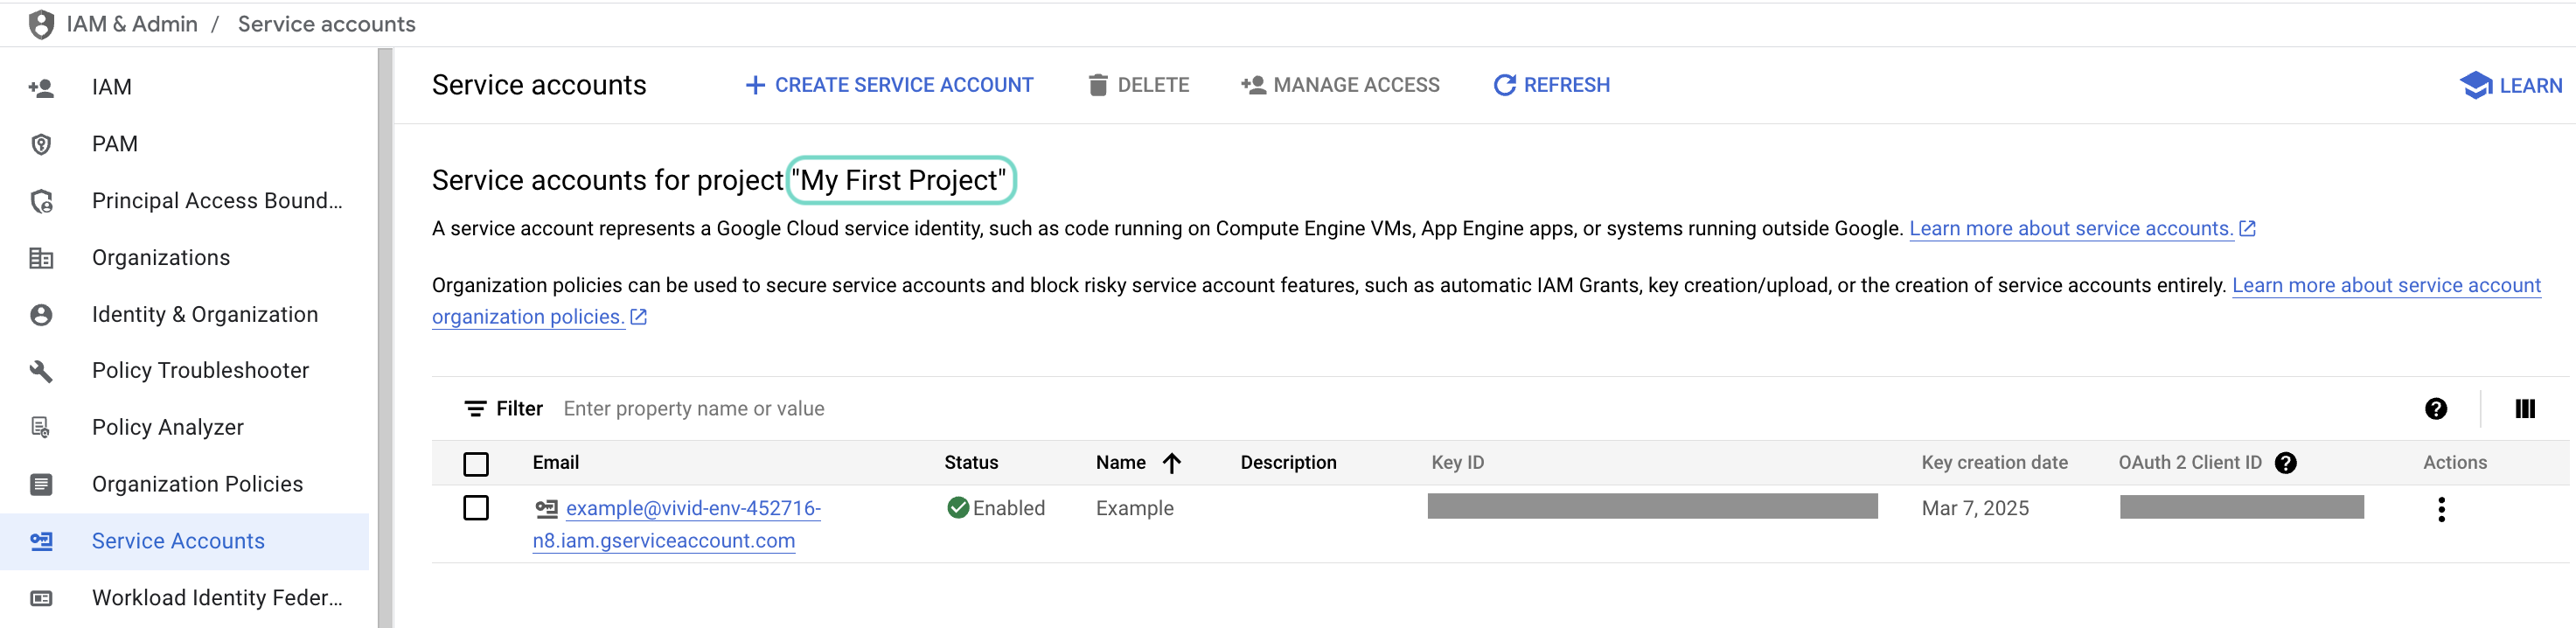 ダッシュボードのスコープを確認します。
使用するサービスアカウントのメールをクリックします。
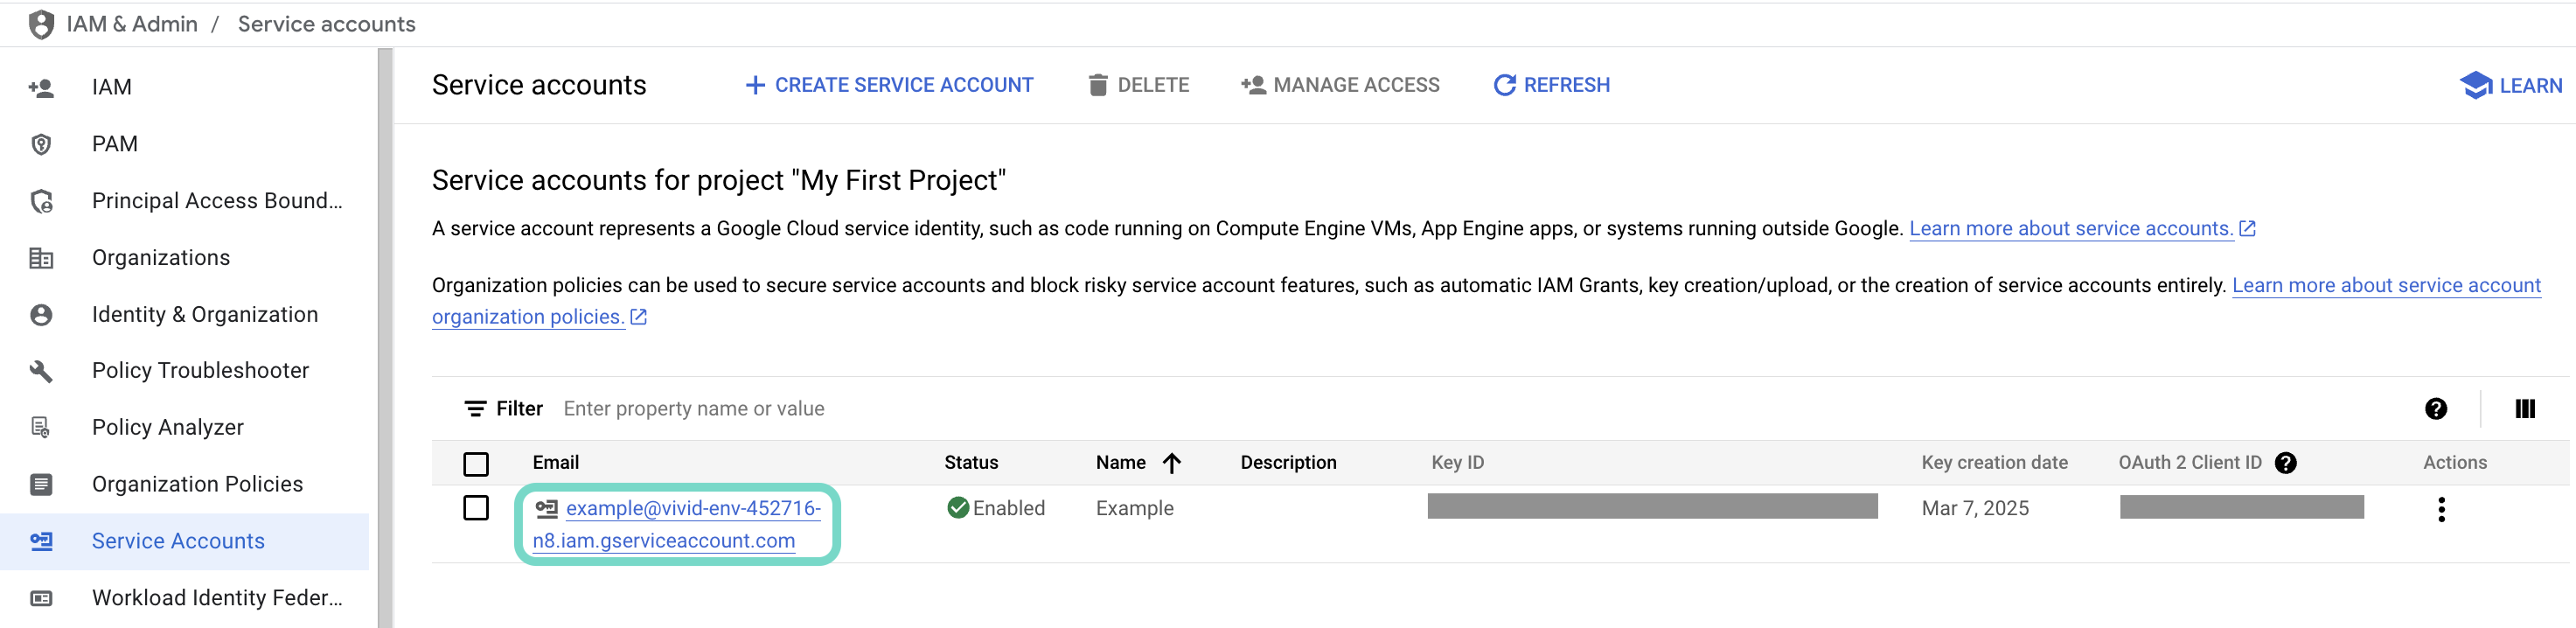 使用するサービスアカウントのメールをクリックします。
サービスアカウントのメールをコピーし、後でコネクションを設定するために保存します。
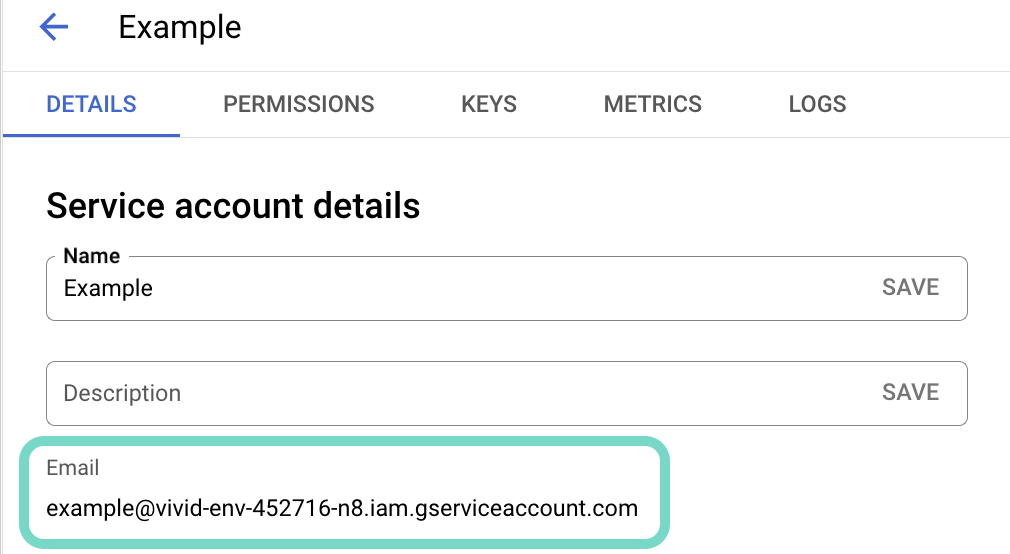 アカウントのメールをコピーします。
キータブに移動します。
秘密鍵を生成し、JSON形式でダウンロードします。キーは1回しかダウンロードできません。
JSONファイルを開き、秘密鍵全体を-----BEGIN PRIVATE KEY-----から-----END PRIVATE KEY-----\nまで(両端を含む)コピーして、後でコネクションを設定するために保存します。
Google BigQuery APIを有効にしてからWorkatoに戻り、コネクションの設定を完了します。
Google BigQueryに接続する
Google BigQueryへの接続手順を表示

WorkatoでGoogle BigQueryへのコネクションを確立するには、次の手順を実行します。
Google BigQueryを検索し、アプリとして選択します。
接続先のGoogle BigQueryインスタンスを識別する、コネクションの一意の名前をコネクション名フィールドに入力します。
コネクションを保存する予定のプロジェクトまたはフォルダを選択するには、ロケーションドロップダウンメニューを使用します。
Authentication typeドロップダウンメニューで、OAuth 2.0またはService accountを選択します。
Authentication typeがService accountの場合は、次の手順を完了します:
サービスアカウントのメールアドレスをGCPプロジェクトサービスアカウントメールフィールドに入力します。
サービスアカウントの秘密鍵を秘密鍵フィールドに入力します。
詳細設定セクションを展開し、コネクションでリクエストするスコープを選択します。
Googleでサインインをクリックします。
WorkatoによるGoogleアカウントへのアクセスを承認するよう求められたら、許可をクリックします。
Google BigQueryロール要件
各ツールの利用可否は、接続済みアカウントに付与された権限によって異なります。必要な権限なしで行われたリクエストは、部分的な結果ではなく、権限拒否の結果を返します。ロール機能の完全なリストについては、Google Cloud BigQuery IAMロールと権限を参照してください。
プロジェクトプロパティ設定
Google BigQuery MCPサーバーは、動作とデフォルトを制御するために、次のプロジェクトレベルのプロパティをサポートしています:
| プロジェクトレベルのプロパティ | 説明 |
|---|---|
| billing_project_id | ジョブを作成し、クエリ料金を負担するGoogle Cloudプロジェクトの課金プロジェクトIDを入力します。このプロジェクトにはbigquery.jobs.create権限が必要です。 |
| default_location | LLMがロケーションパラメーターを省略した場合のデフォルト解決方法を入力します。利用可能な場合、ロケーションはデータセットメタデータから自動解決されます。 |
| query_timeout_ms | ポーリング用のジョブ参照を返す前に、run_queryとexecute_sqlが同期的に待機する時間を設定します。デフォルトは30,000msです。 |
| default_max_results | LLMがmax_resultsを省略した場合に、結果の各ページに表示するデフォルトの行数を入力します。デフォルトは100行です。 |
| max_response_bytes | 各ページで返されるシリアライズ済みペイロードのサーバー側制限を入力します。デフォルトは1 MBです。 |
| default_maximum_bytes_billed | LLMがmaximum_bytes_billedを省略した場合にクエリへ適用する使用額制限を入力します。デフォルトでは制限はありません。 |
| max_maximum_bytes_billed | ガバナンス対象のEnvironment向けに、サーバー側の厳格な使用額制限を入力します。デフォルトでは制限はありません。 |
| read_only | このフラグを有効にすると、データ変更ツールが無効になります。デフォルトはOffです。 |
| on_demand_price_per_tib | オンデマンドコストの概算に使用する価格の前提を入力します。デフォルトは$6.25/TiB(USマルチリージョンのオンデマンド定価)です。 |
| job_labels | このサーバーが作成するすべてのジョブに付加する、デプロイメント定義の追加ラベルを指定します。 |
プロジェクトレベルのプロパティ設定手順を表示
プロジェクトレベルのプロパティを設定するには、次の手順を実行します:
Workatoアカウントにサインインし、プロジェクトに移動します。
MCPサーバーを含むプロジェクトに移動します。
Settingsタブをクリックします。
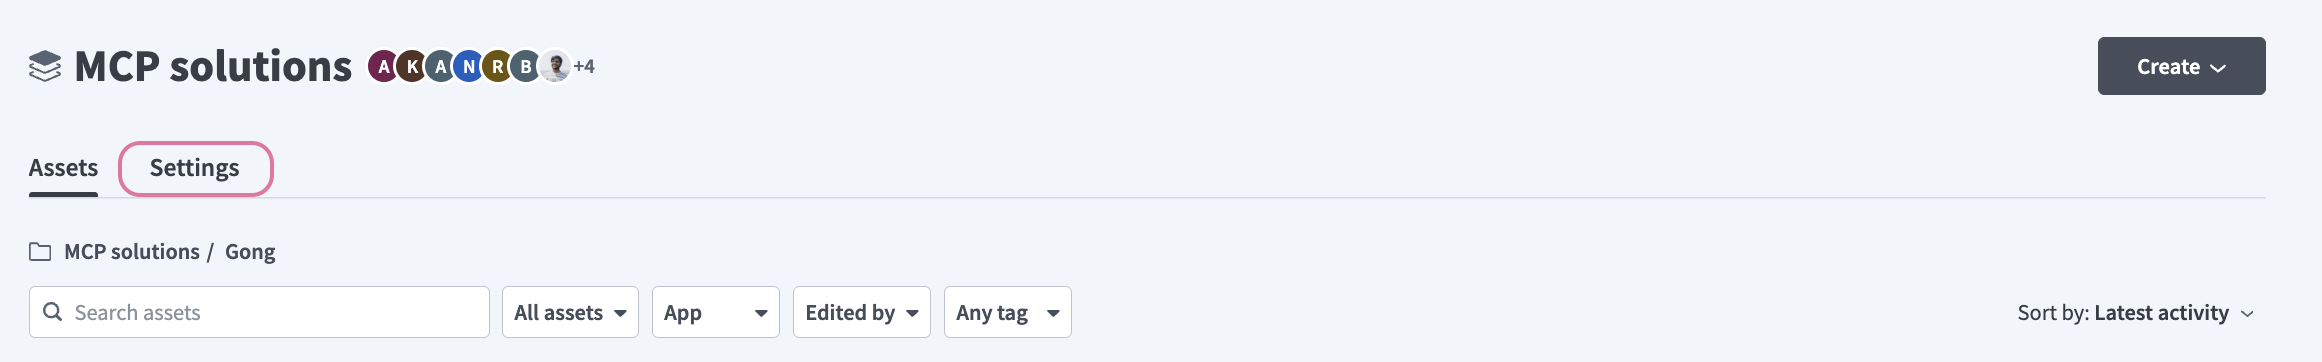 Settingsタブをクリックします。
プロジェクトプロパティを選択します。
更新するプロジェクトプロパティに移動し、Edit(鉛筆)アイコンをクリックします。
Valueフィールドに移動して変更を加えます。たとえば、query_timeout_msを25,00msに設定するか、default_max_resultsを50に設定します。
Google BigQuery MCPサーバーツールの使用方法
利用可能なツールの詳細については、次のセクションを参照してください:
list_datasetsツール
list_datasetsツールは、BigQueryプロジェクト内のデータセットを一覧表示します。 LLMはこのツールを使用して、プロジェクトで利用可能なデータセットを検出し、必要に応じてラベルでフィルタリングし、クエリ実行前にウェアハウス構造を理解します。
質問例:
What datasets are available in my project?Show me all datasets with the environment label set to production.List all datasets in alphabetical order with their descriptions.
get_datasetツール
get_datasetツールは、ロケーション、説明、デフォルトの有効期限設定など、特定のデータセットのメタデータを取得します。 LLMはこのツールを使用して、データセット設定を理解し、ジョブルーティングのリージョンを判断し、クエリ実行前にデータセットへのアクセス可能性を確認します。
質問例:
Where is the analytics dataset located?What's the description and default expiration for the raw_data dataset?Get the metadata for the events dataset to confirm its region.
list_tablesツール
list_tablesツールは、データセット内のテーブル、ビュー、および外部テーブルを一覧表示します。 LLMはこのツールを使用して、データセット内で利用可能なテーブルを確認し、分析にアクセス可能なデータを理解します。
質問例:
What tables are in the analytics dataset?Show me all views in the staging dataset.List all external tables available in the data_imports dataset.
get_tableツール
get_tableツールは、テーブルの完全なスキーマ、行数とバイト数、パーティショニングとクラスタリングの設定、およびストリーミングバッファーのステータスを取得します。 LLMはこのツールを使用して、SQLを作成する前にテーブル構造を把握し、利用可能な列を理解し、スキャンコストを削減できるインデックス設定について学習します。
質問例:
Show me the schema for the customers table.What are the partitioning and clustering columns for the events table?How many rows and bytes does the transactions table contain?
preview_table_rowsツール
preview_table_rowsツールは、クエリを実行したりクエリ料金を発生させたりせずに、サンプル行をテーブルから直接読み取ります。 LLMはこのツールを使用して、実際のデータ値を確認し、データ品質を検証し、コストやSQL実行のオーバーヘッドなしでテーブルの内容をサンプリングします。
質問例:
Preview the first 20 rows of the users table.Show me some examples of data in the customer_events table.Get a sample of rows from the products table, showing just the name and price columns.
estimate_query_costツール
estimate_query_costツールは、SQLステートメントを検証し、ドライランではコストが発生しないため、クエリを実行せずにスキャンされるバイト数を見積もります。 LLMはこのツールを使用して、SQL構文を確認し、クエリが参照するテーブルを理解し、高コストなスキャンが実行される前にユーザーへコスト見積もりを提示します。
質問例:
What would this query cost: SELECT * FROM huge_table WHERE year = 2024?Estimate the cost of a query joining customers and orders on the last month's data.Check if my query is syntactically valid and how many bytes it would scan.
run_queryツール
run_queryツールは、読み取り専用のGoogleSQL SELECTクエリを実行します。クエリがすぐに完了した場合、行がただちに返されます。それ以外の場合はポーリング用のジョブ参照が返されます。LLMはこれをエラーではなく通常の進行として扱う必要があります。 LLMはこのツールを使用して、パラメーター化された分析クエリを実行し、結果を取得します。
質問例:
Query the customers table to find all customers created in the last 30 days.Run a SELECT statement with a parameter to find orders where the amount exceeds @min_amount.Execute a query that joins three tables and returns the top 100 results by revenue.
get_query_resultsツール
get_query_resultsツールは、クエリジョブをポーリングし、ジョブIDとロケーションに基づいてページ分割された結果行を取得します。このツールは、未完了のジョブをエラーではなく実行中として報告します。 LLMはこのツールを使用して、長時間実行クエリの結果を取得し、複数ページの結果セットを処理します。
質問例:
Get the results of job ID abc123 in the us-central1 region.Fetch the next page of results from my query using this page token.Poll the status of a query that was still running earlier.
execute_sqlツール
execute_sqlツールは、許可リストに含まれるデータまたはスキーマを変更する単一のSQLステートメントを実行します。 LLMはこのツールを使用して、行の挿入、更新、削除や、テーブルおよびデータセットの作成、変更、削除を行います。このツールでは、DROP、TRUNCATE、DELETEなどの破壊的なステートメントを実行する前に、ユーザーによる明示的な確認が必要です。それ以外の場合はただちに実行されます。
質問例:
Insert a new row into the customers table with these values.Update all records in the staging table where status equals pending to completed.Delete all test data from the events table that were created in the last hour.
insert_rowsツール
insert_rowsツールは、任意の重複抑制を使用してJSON行をBigQueryテーブルにストリーミングします。 LLMはこのツールを使用して、会話で生成されたイベント行またはアプリケーション行をテーブルに追加します。このツールは、バッチ全体を単一の成功または失敗として扱うのではなく、各行の結果を個別に報告します。
質問例:
Stream these 50 event records into the events table.Append new user signup records to the users table and report any failures.Insert rows with deduplication IDs to avoid inserting duplicates.
get_jobツール
get_jobツールは、BigQueryジョブのステータス、統計、およびエラーを取得します。 LLMはこのツールを使用して、ジョブがまだ実行中かどうかを確認し、処理済みバイト数と課金対象バイト数を確認します。このツールは、エラーが発生したジョブを失敗として報告します。
質問例:
What's the status of job ID xyz789 in the us region?Show me how many bytes my query processed and whether results came from cache.Get the error details for a job that failed.
cancel_jobツール
cancel_jobツールは、実行中のBigQueryジョブのベストエフォート方式のキャンセルをリクエストします。 LLMはこのツールを使用して、制御不能なクエリが追加コストを発生させる前に停止し、キャンセルされたジョブの最終状態を確認します。
質問例:
Cancel the query job that's been running too long.Stop the data load job in the us-central1 region.Halt this insert operation before it processes more data.
はじめに
MCP serverのツールは、Overviewページのツールセクションで表示および管理できます。ツール管理では、次の機能を利用できます:
ツールを開始する必要があります
LLMは、MCP server connector内のアクティブなツールにのみアクセスできます。
最終更新日: